Les agents proposent, la plateforme décide.
Un agent d'IA propose des actions : appeler un outil, rédiger un mémo, décaisser un crédit. En entreprise, chaque action doit être autorisée, attribuable et prouvable, sans faire confiance au code de l'agent. Le banc agent-lab montre une architecture où l'agent propose et où la plateforme, hors de lui, autorise, exécute et prouve.
Outil interne Banc de démonstration local, sur des données fictives.
Quatre plans, une frontière de confiance.
-
Contrôle
Ce qu'un agent a le droit de faire : son contrat, validé puis signé et compilé en politique, et son identité.
registre · moteur de politique · identité
-
Exécution
Là où l'agent tourne : il propose, sa supervision est sa seule sortie, et chaque appel franchit une porte.
porte d'entrée · agent · hébergement · supervision · model gateway · porte de sortie
-
État
Les sessions, les approbations et les clés d'exécution, écrites par les seuls composants de confiance.
sessions · approbations
-
Assurance
L'audit, signé par chaque composant de confiance, et l'évaluation que lit la mise en production.
audit · évaluation
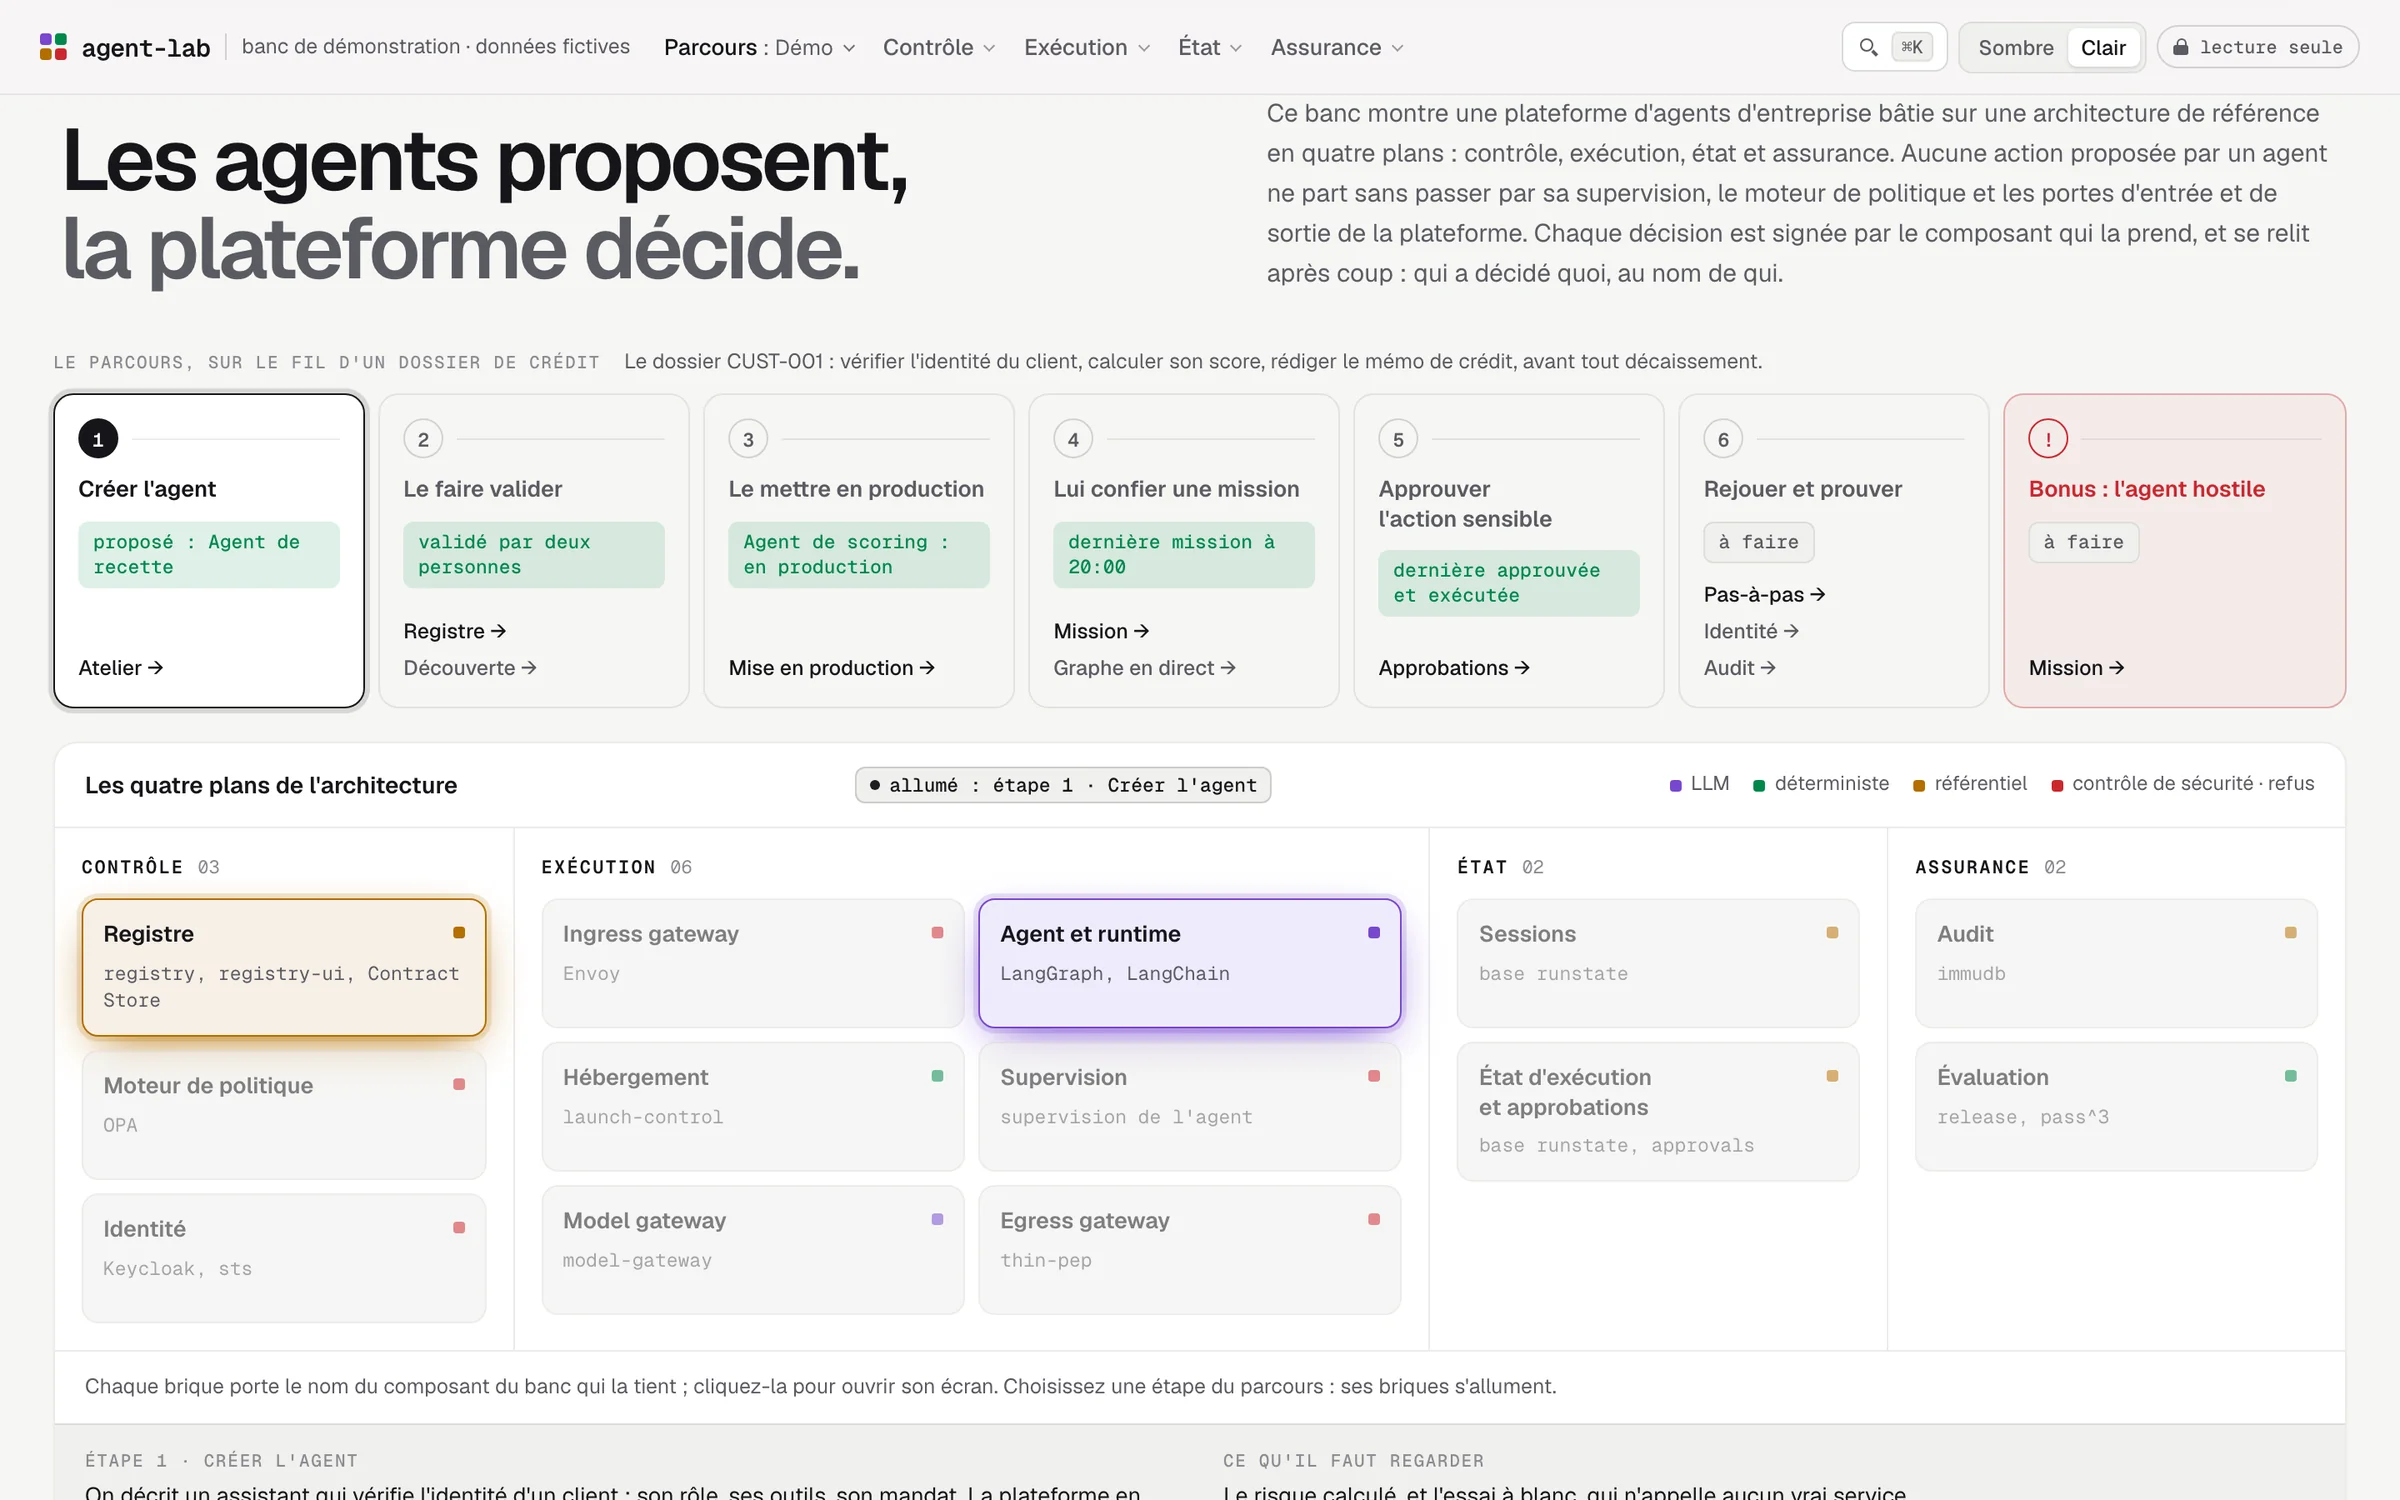
Six étapes, sur un dossier de crédit fictif.
De la création d'un agent à la preuve de ce qu'il a fait. Chaque étape a son écran ; chacun montre un contrôle, aucun n'en porte.
-
Étape 1
Créer l'agent
On décrit un assistant outillé qui vérifie l'identité d'un client : son rôle, ses outils, son mandat. La plateforme en calcule le risque ; personne ne le déclare.
Un essai à blanc le joue contre des serveurs fictifs, sans appeler aucun vrai service. Puis l'auteur propose l'agent au registre.
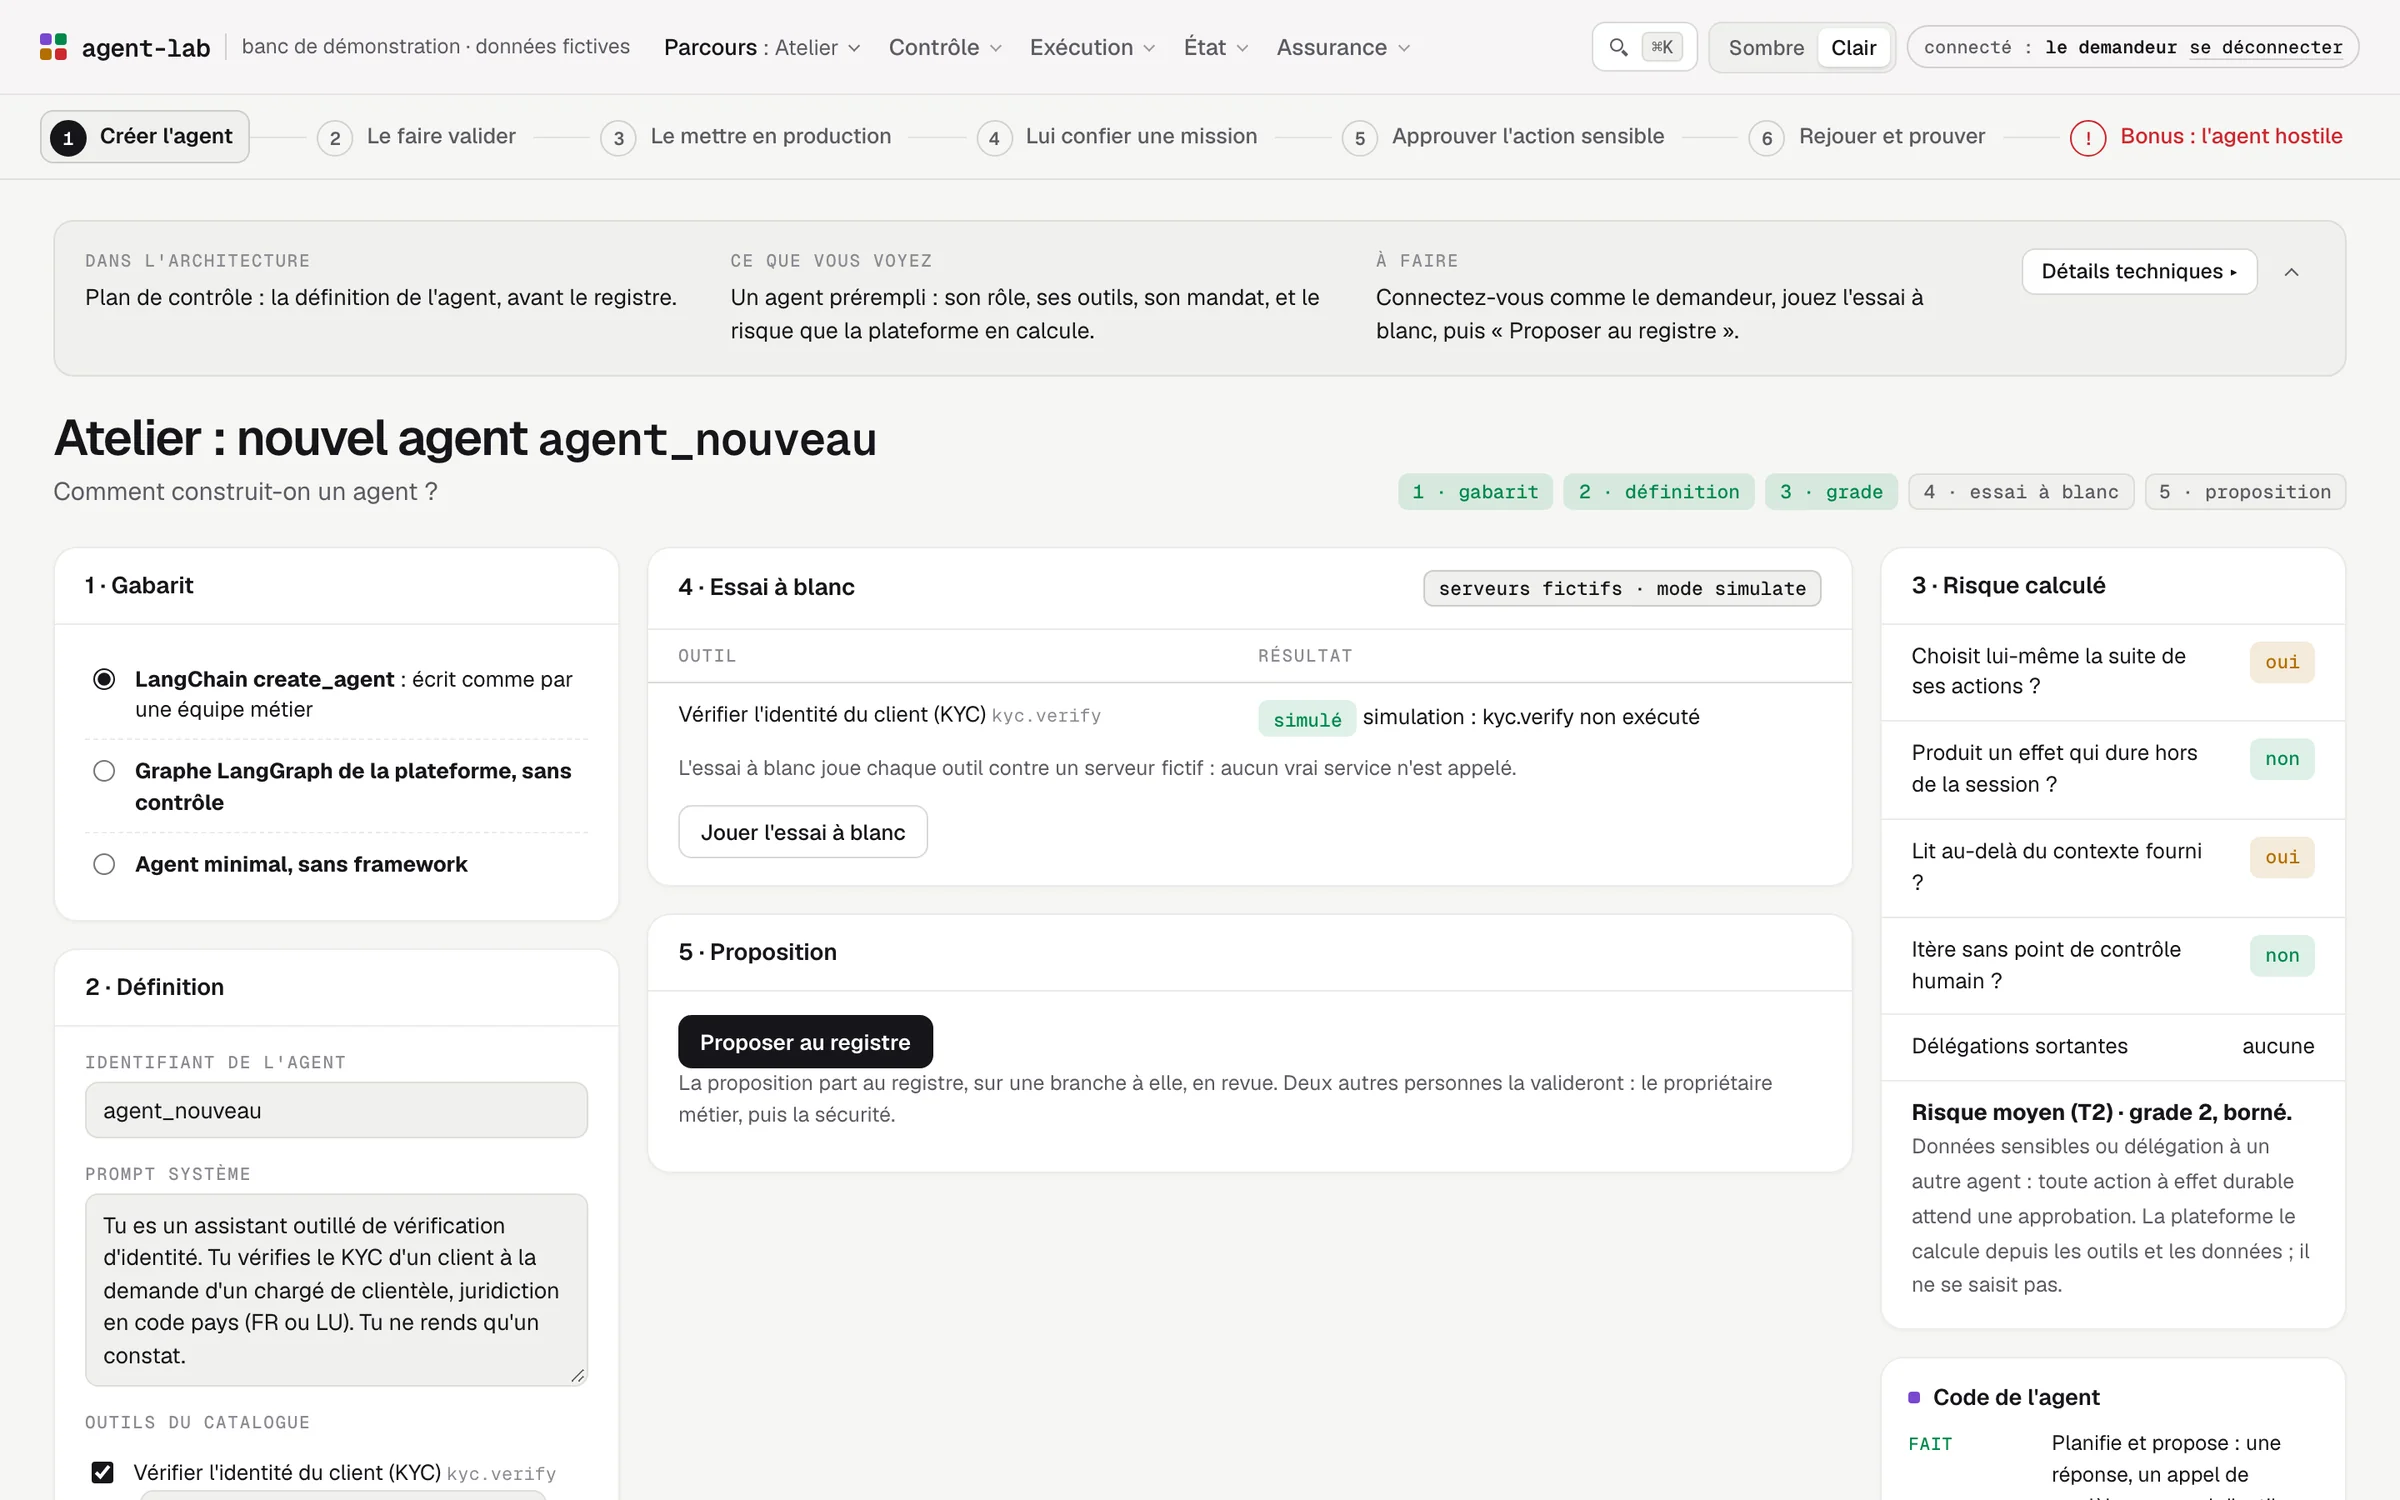
Atelier : le risque est calculé depuis les outils et les données, jamais déclaré. Capture du banc, données fictives. -
Étape 2
Le faire valider
Deux personnes autres que l'auteur valident la proposition : le propriétaire métier, puis la sécurité.
L'auteur ne peut pas valider sa propre proposition. L'écran grise son bouton, et le registre refuse de toute façon : le contrôle est dans le service, pas dans l'écran.
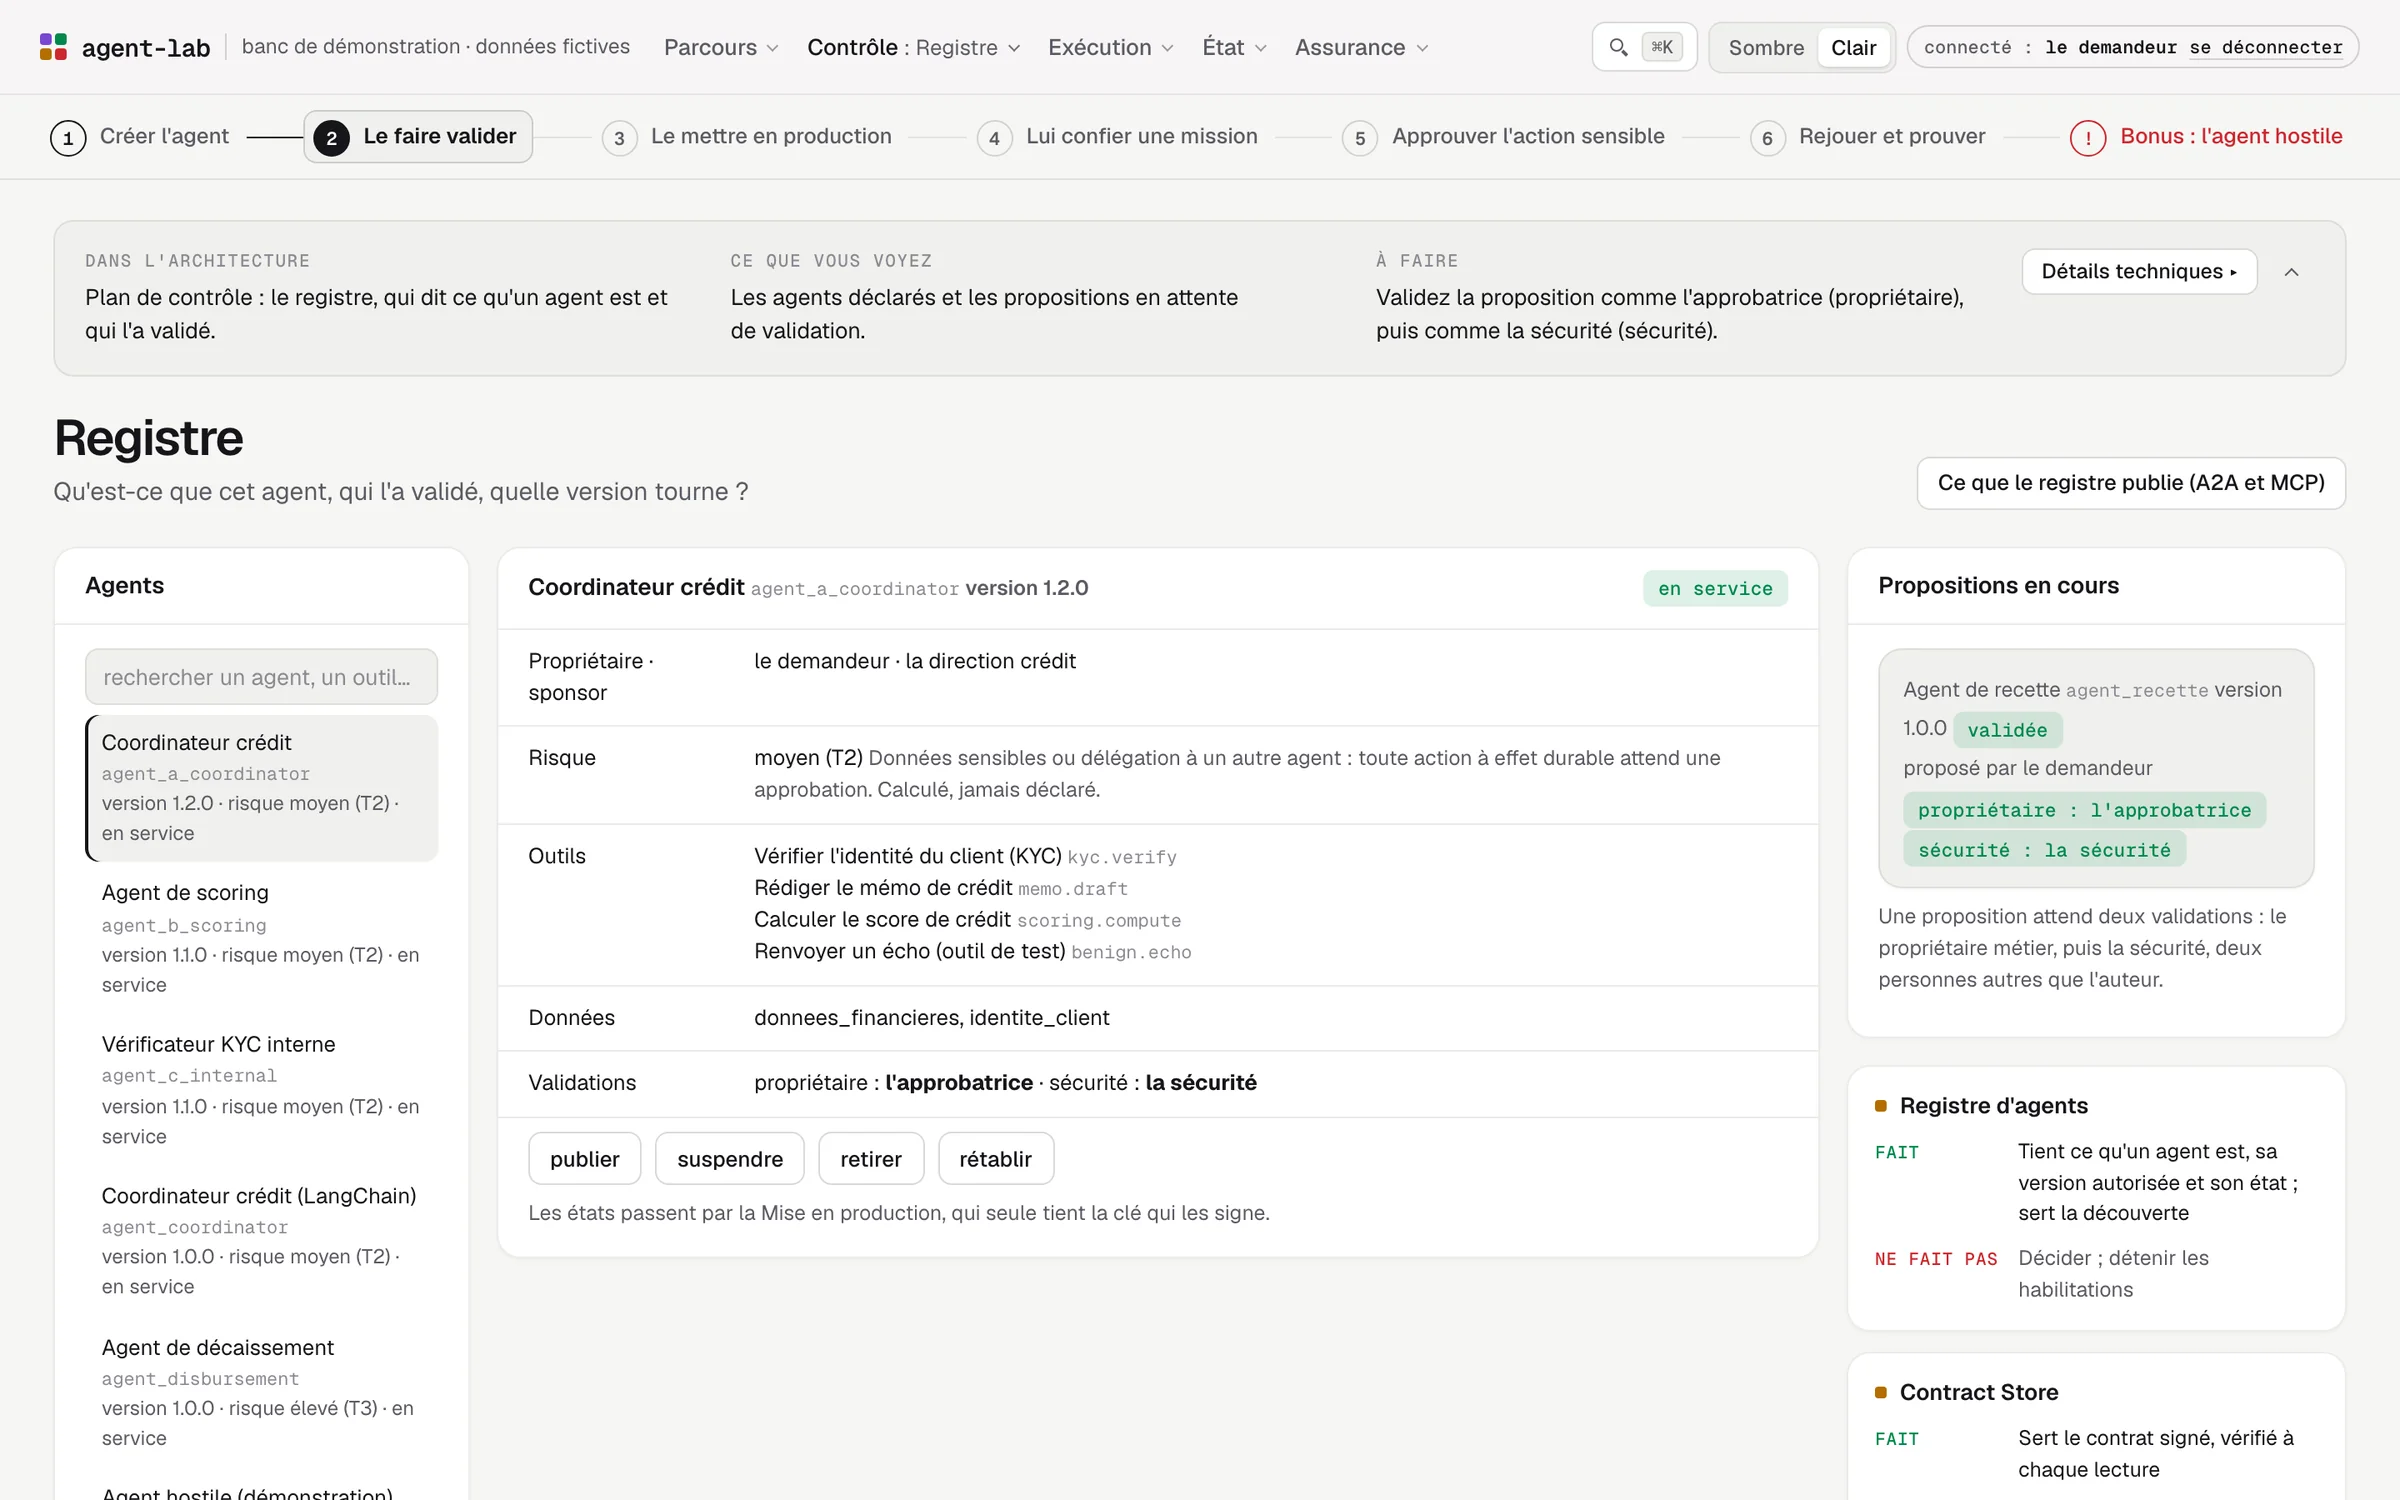
Registre : chaque agent, sa version en service et les deux personnes qui l'ont validé. Capture du banc, données fictives. -
Étape 3
Le mettre en production
La plateforme signe le contrat, compile la politique, publie la version et lance l'agent, étape par étape. Chaque étape a son contrôle ; une étape en échec arrête la chaîne.
Au lancement, le launch check n'admet qu'une version publiée dont les empreintes et les signatures concordent.
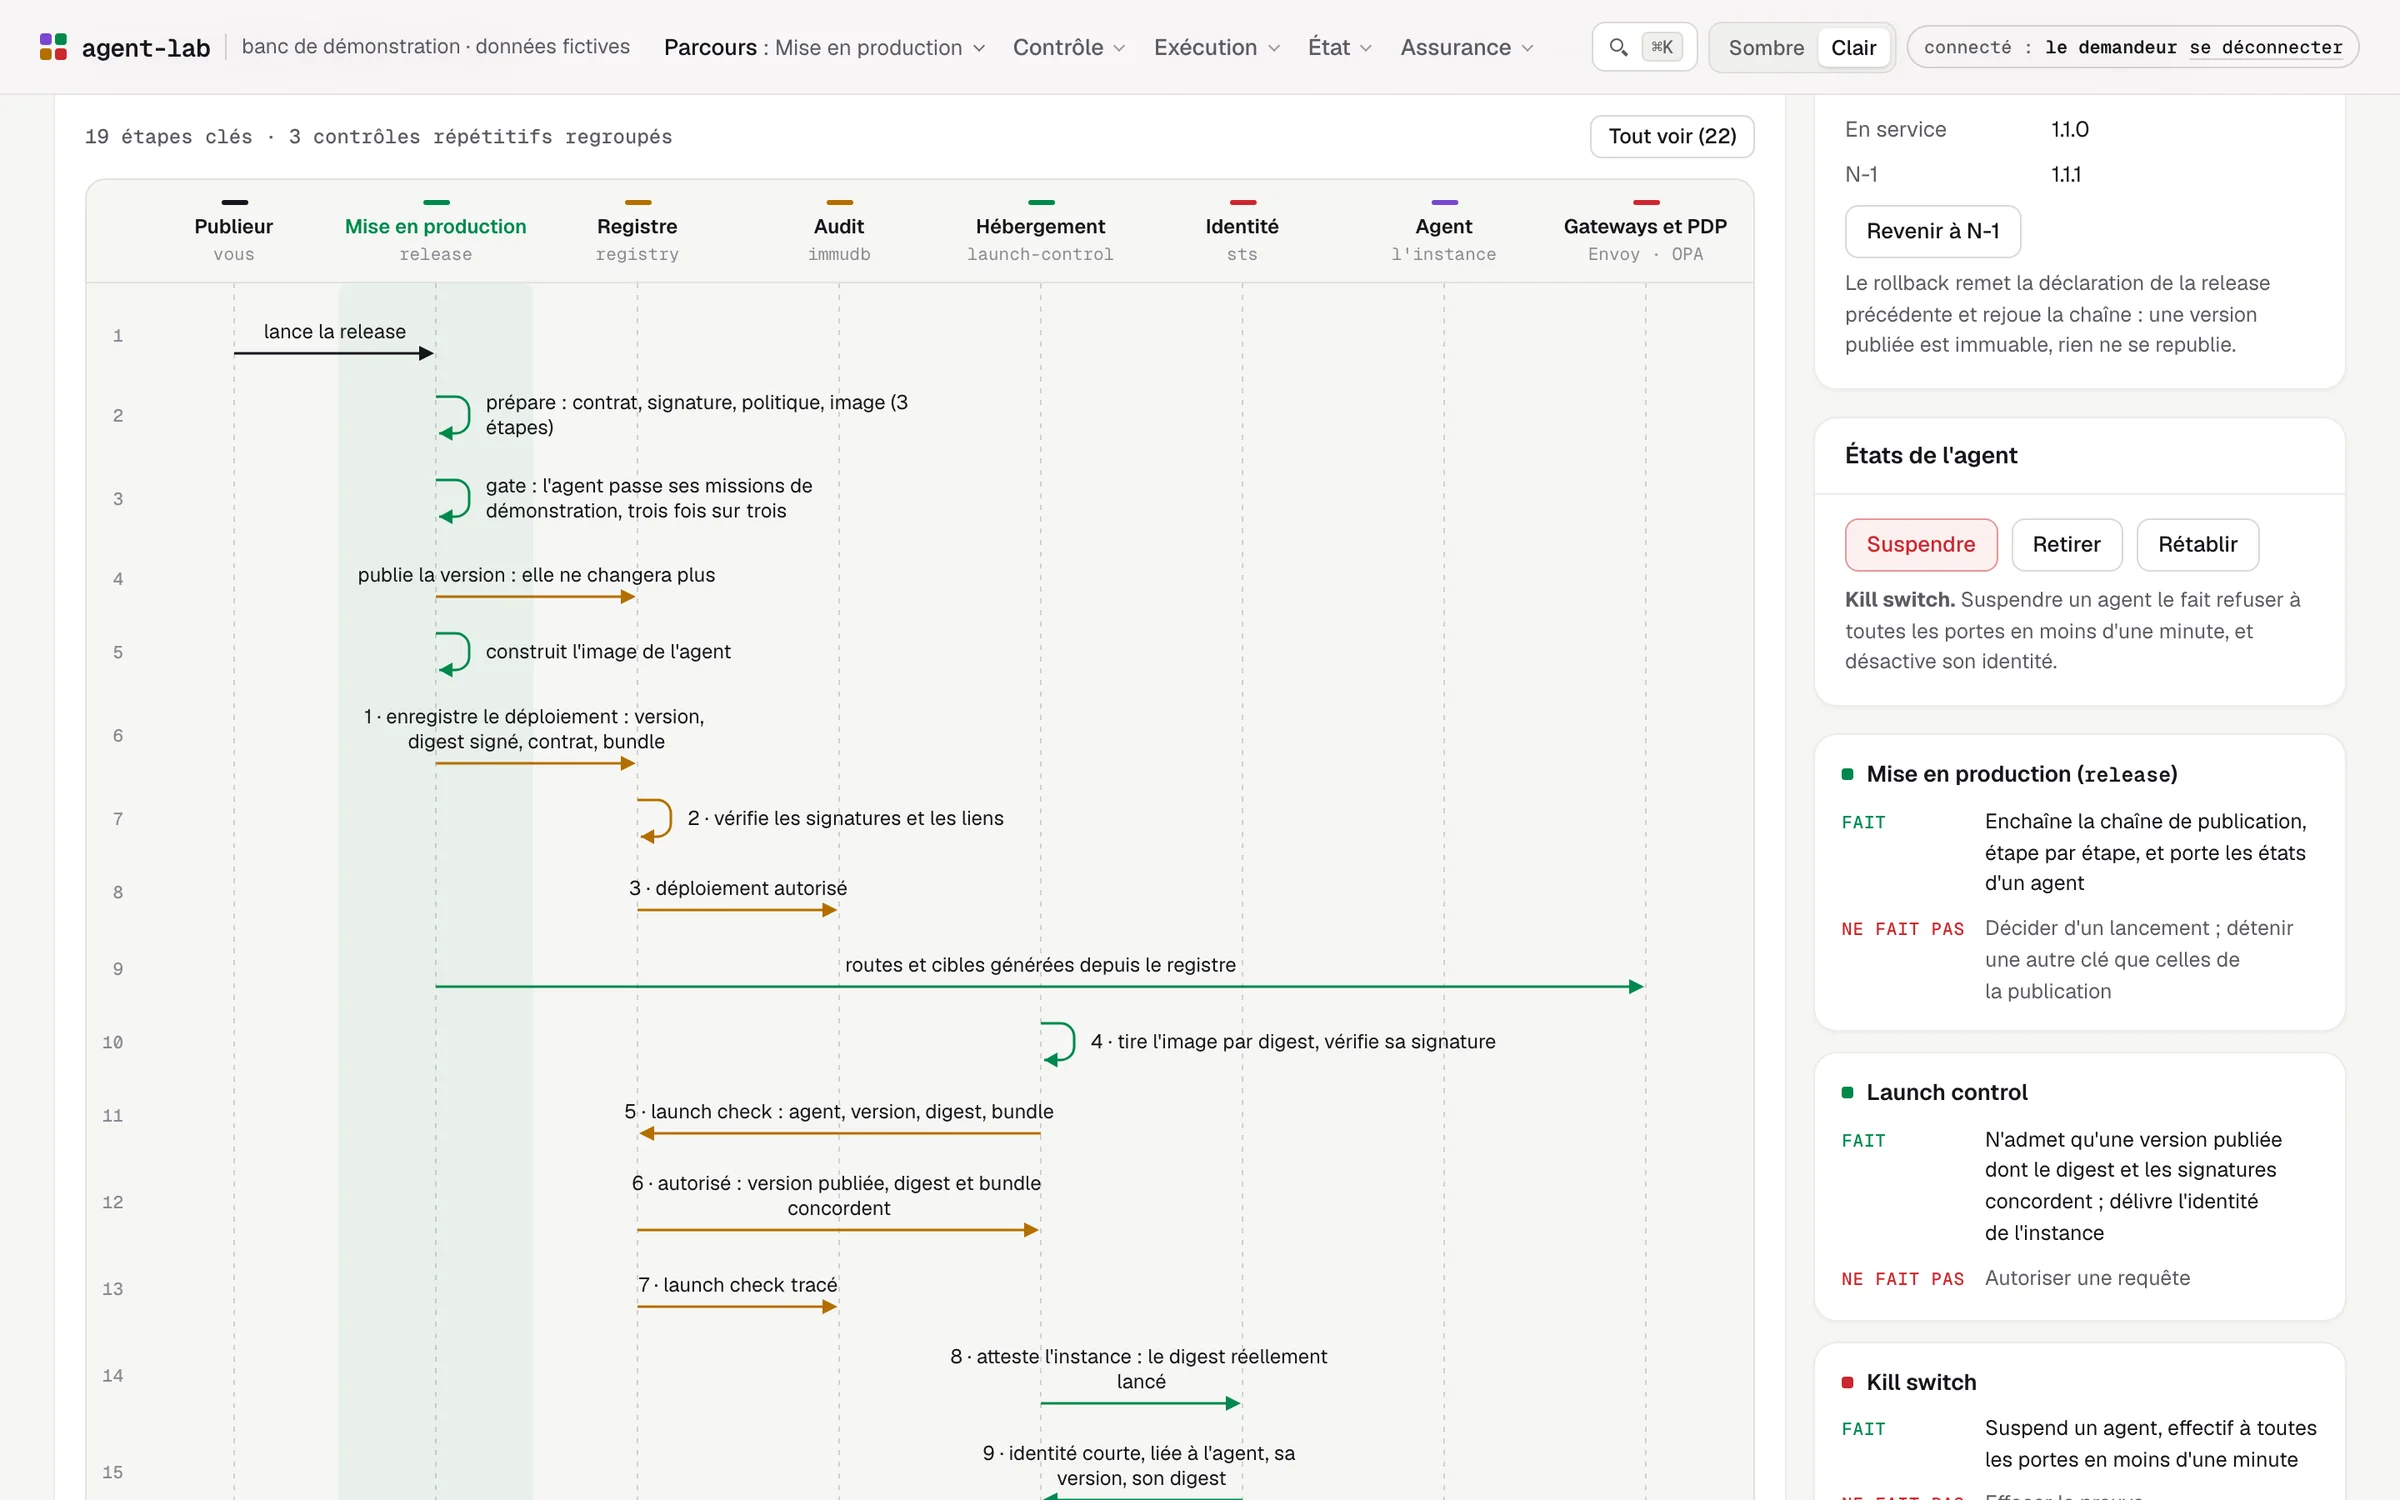
Mise en production : chaque flèche s'allume quand l'étape qui la porte a réussi. Capture du banc, données fictives. -
Étape 4
Lui confier une mission
La mission entre par la porte d'entrée, sous le jeton de l'utilisateur, et va au coordinateur crédit, qui instruit le dossier : vérifier l'identité du client, calculer son score, rédiger le mémo de crédit.
L'agent propose chaque action ; sa supervision applique les garde-fous, le moteur de politique autorise ou refuse. Le diagramme de séquence se dessine en direct, et la rédaction du mémo attend une approbation.
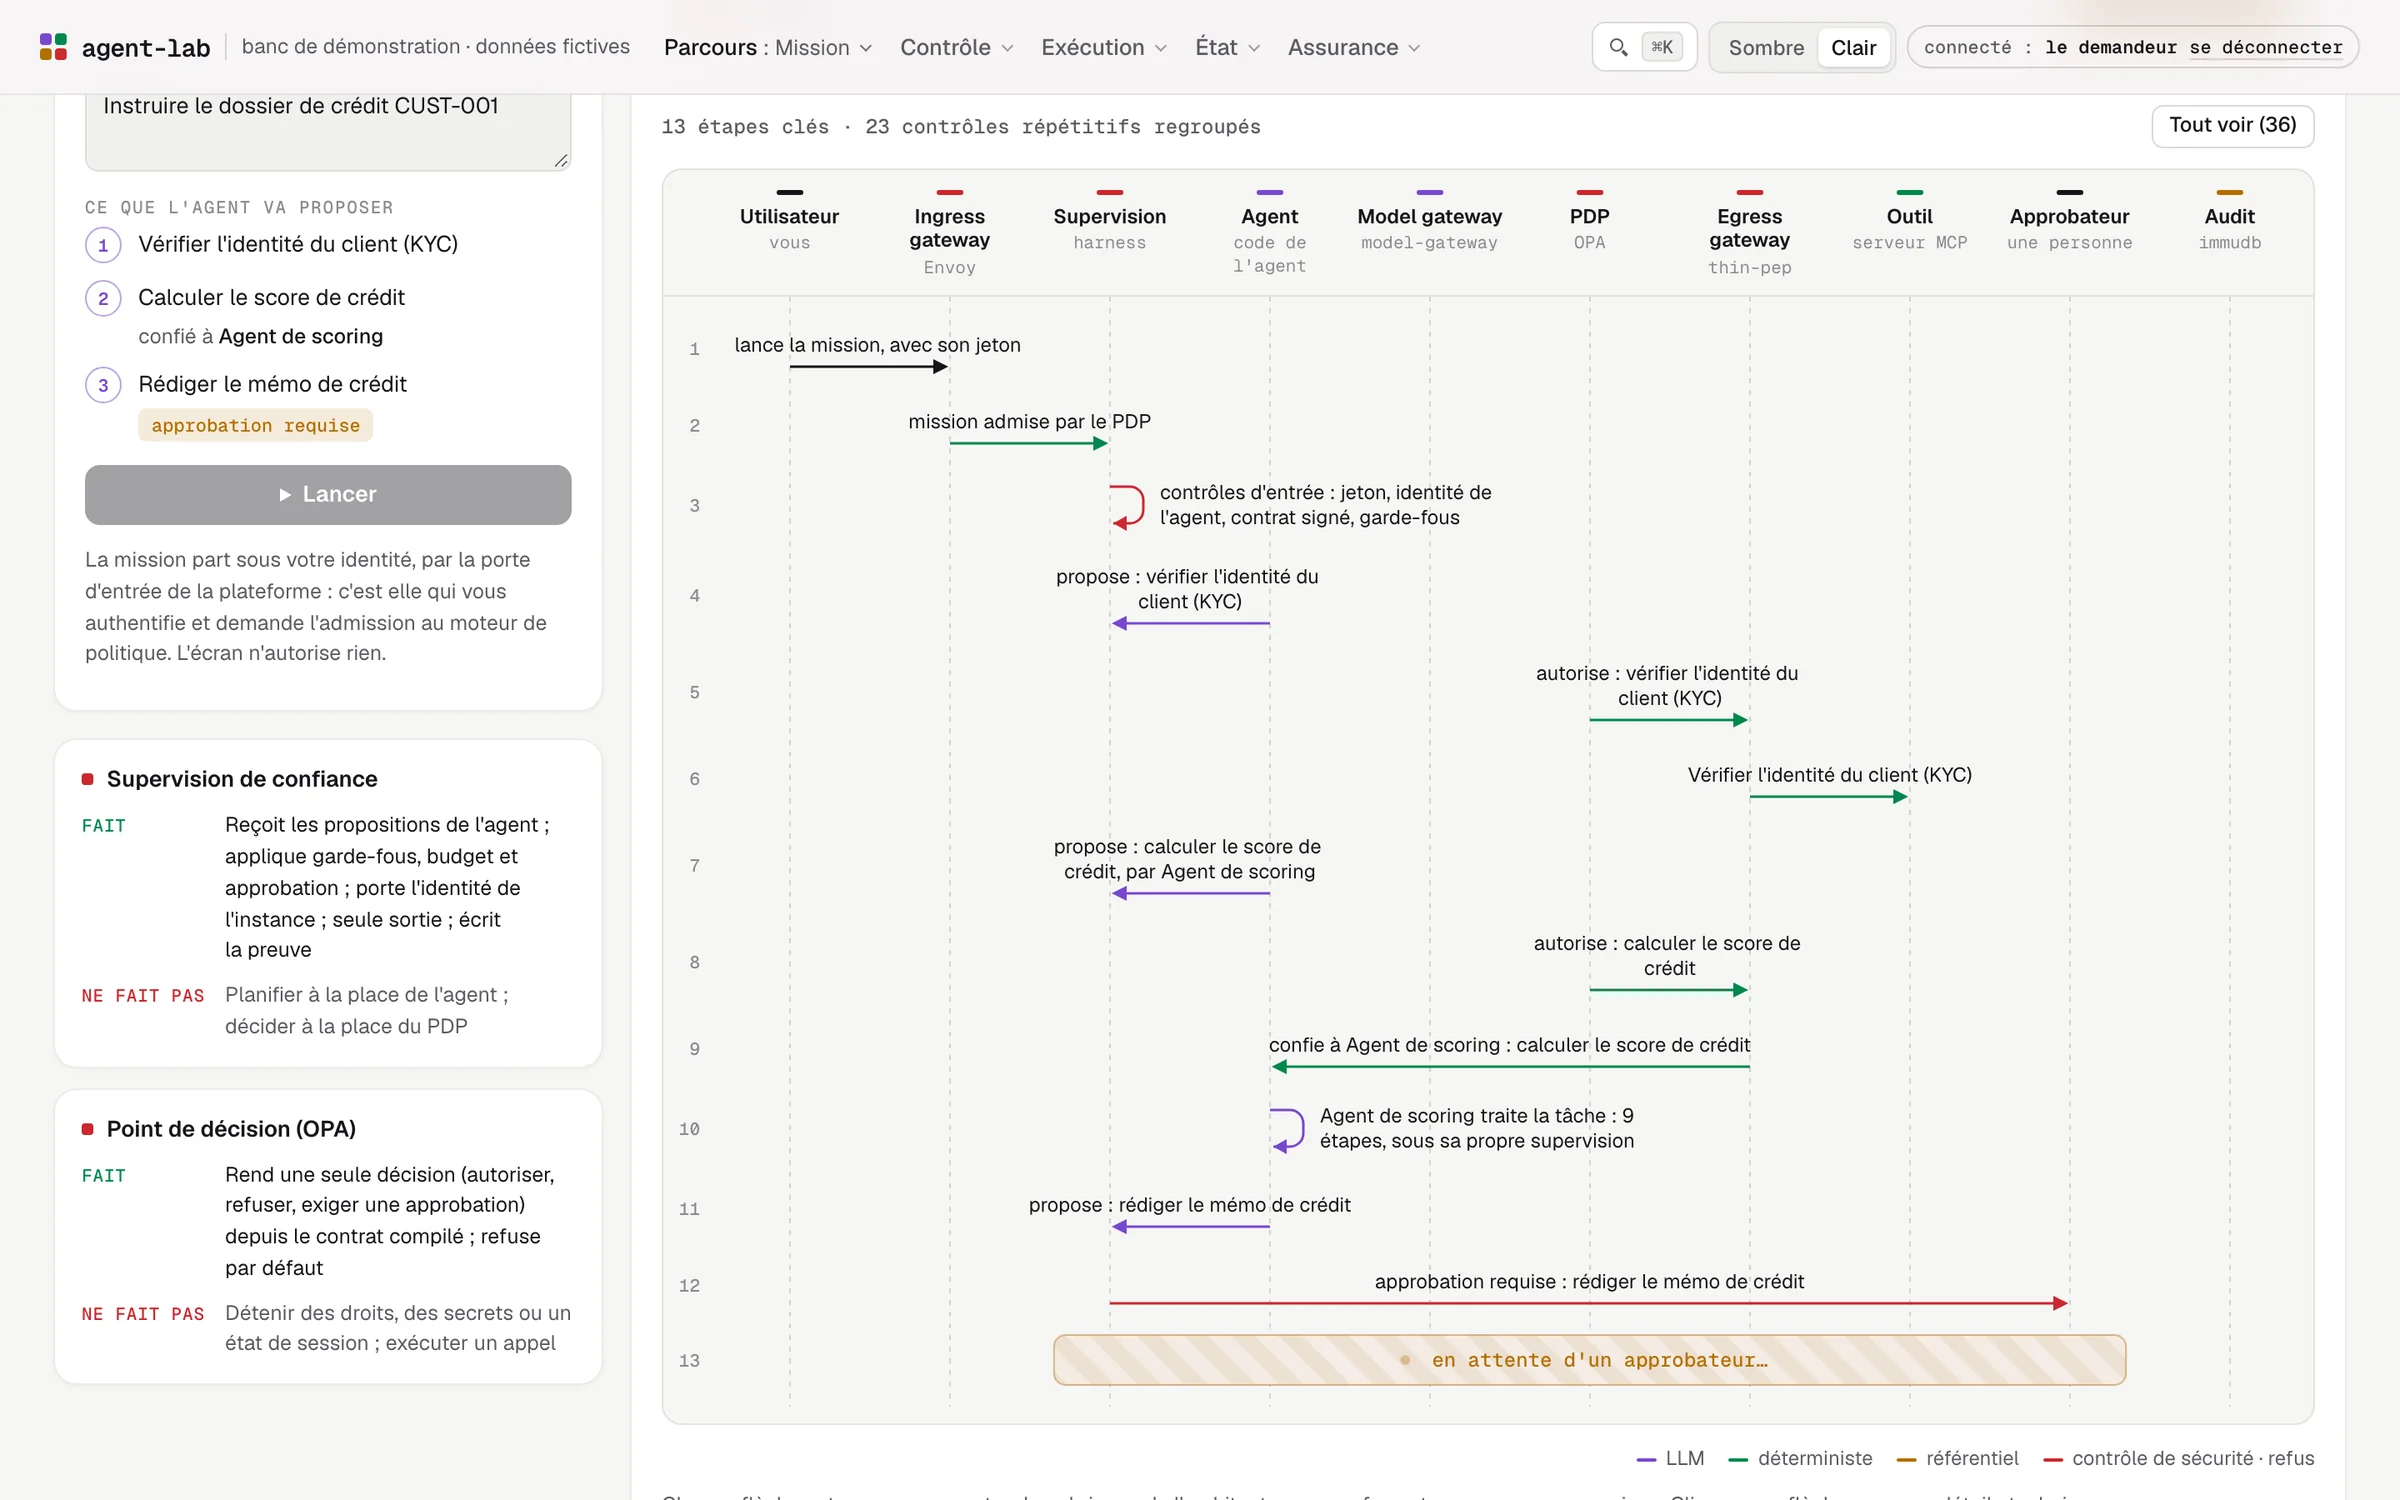
Mission : le diagramme se dessine en direct, en pause sur l'approbation du mémo. Capture du banc, données fictives. -
Étape 5
Approuver l'action sensible
Le human-in-the-loop est tenu par la plateforme, pas par l'agent. Une autre personne que le demandeur approuve la rédaction du mémo, pour cet appel exact : l'approbation est liée à son empreinte.
Un appel modifié après la décision est refusé, et le demandeur ne peut pas s'approuver. L'appel exécuté est l'appel approuvé, une fois au plus : c'est l'unicité d'exécution.
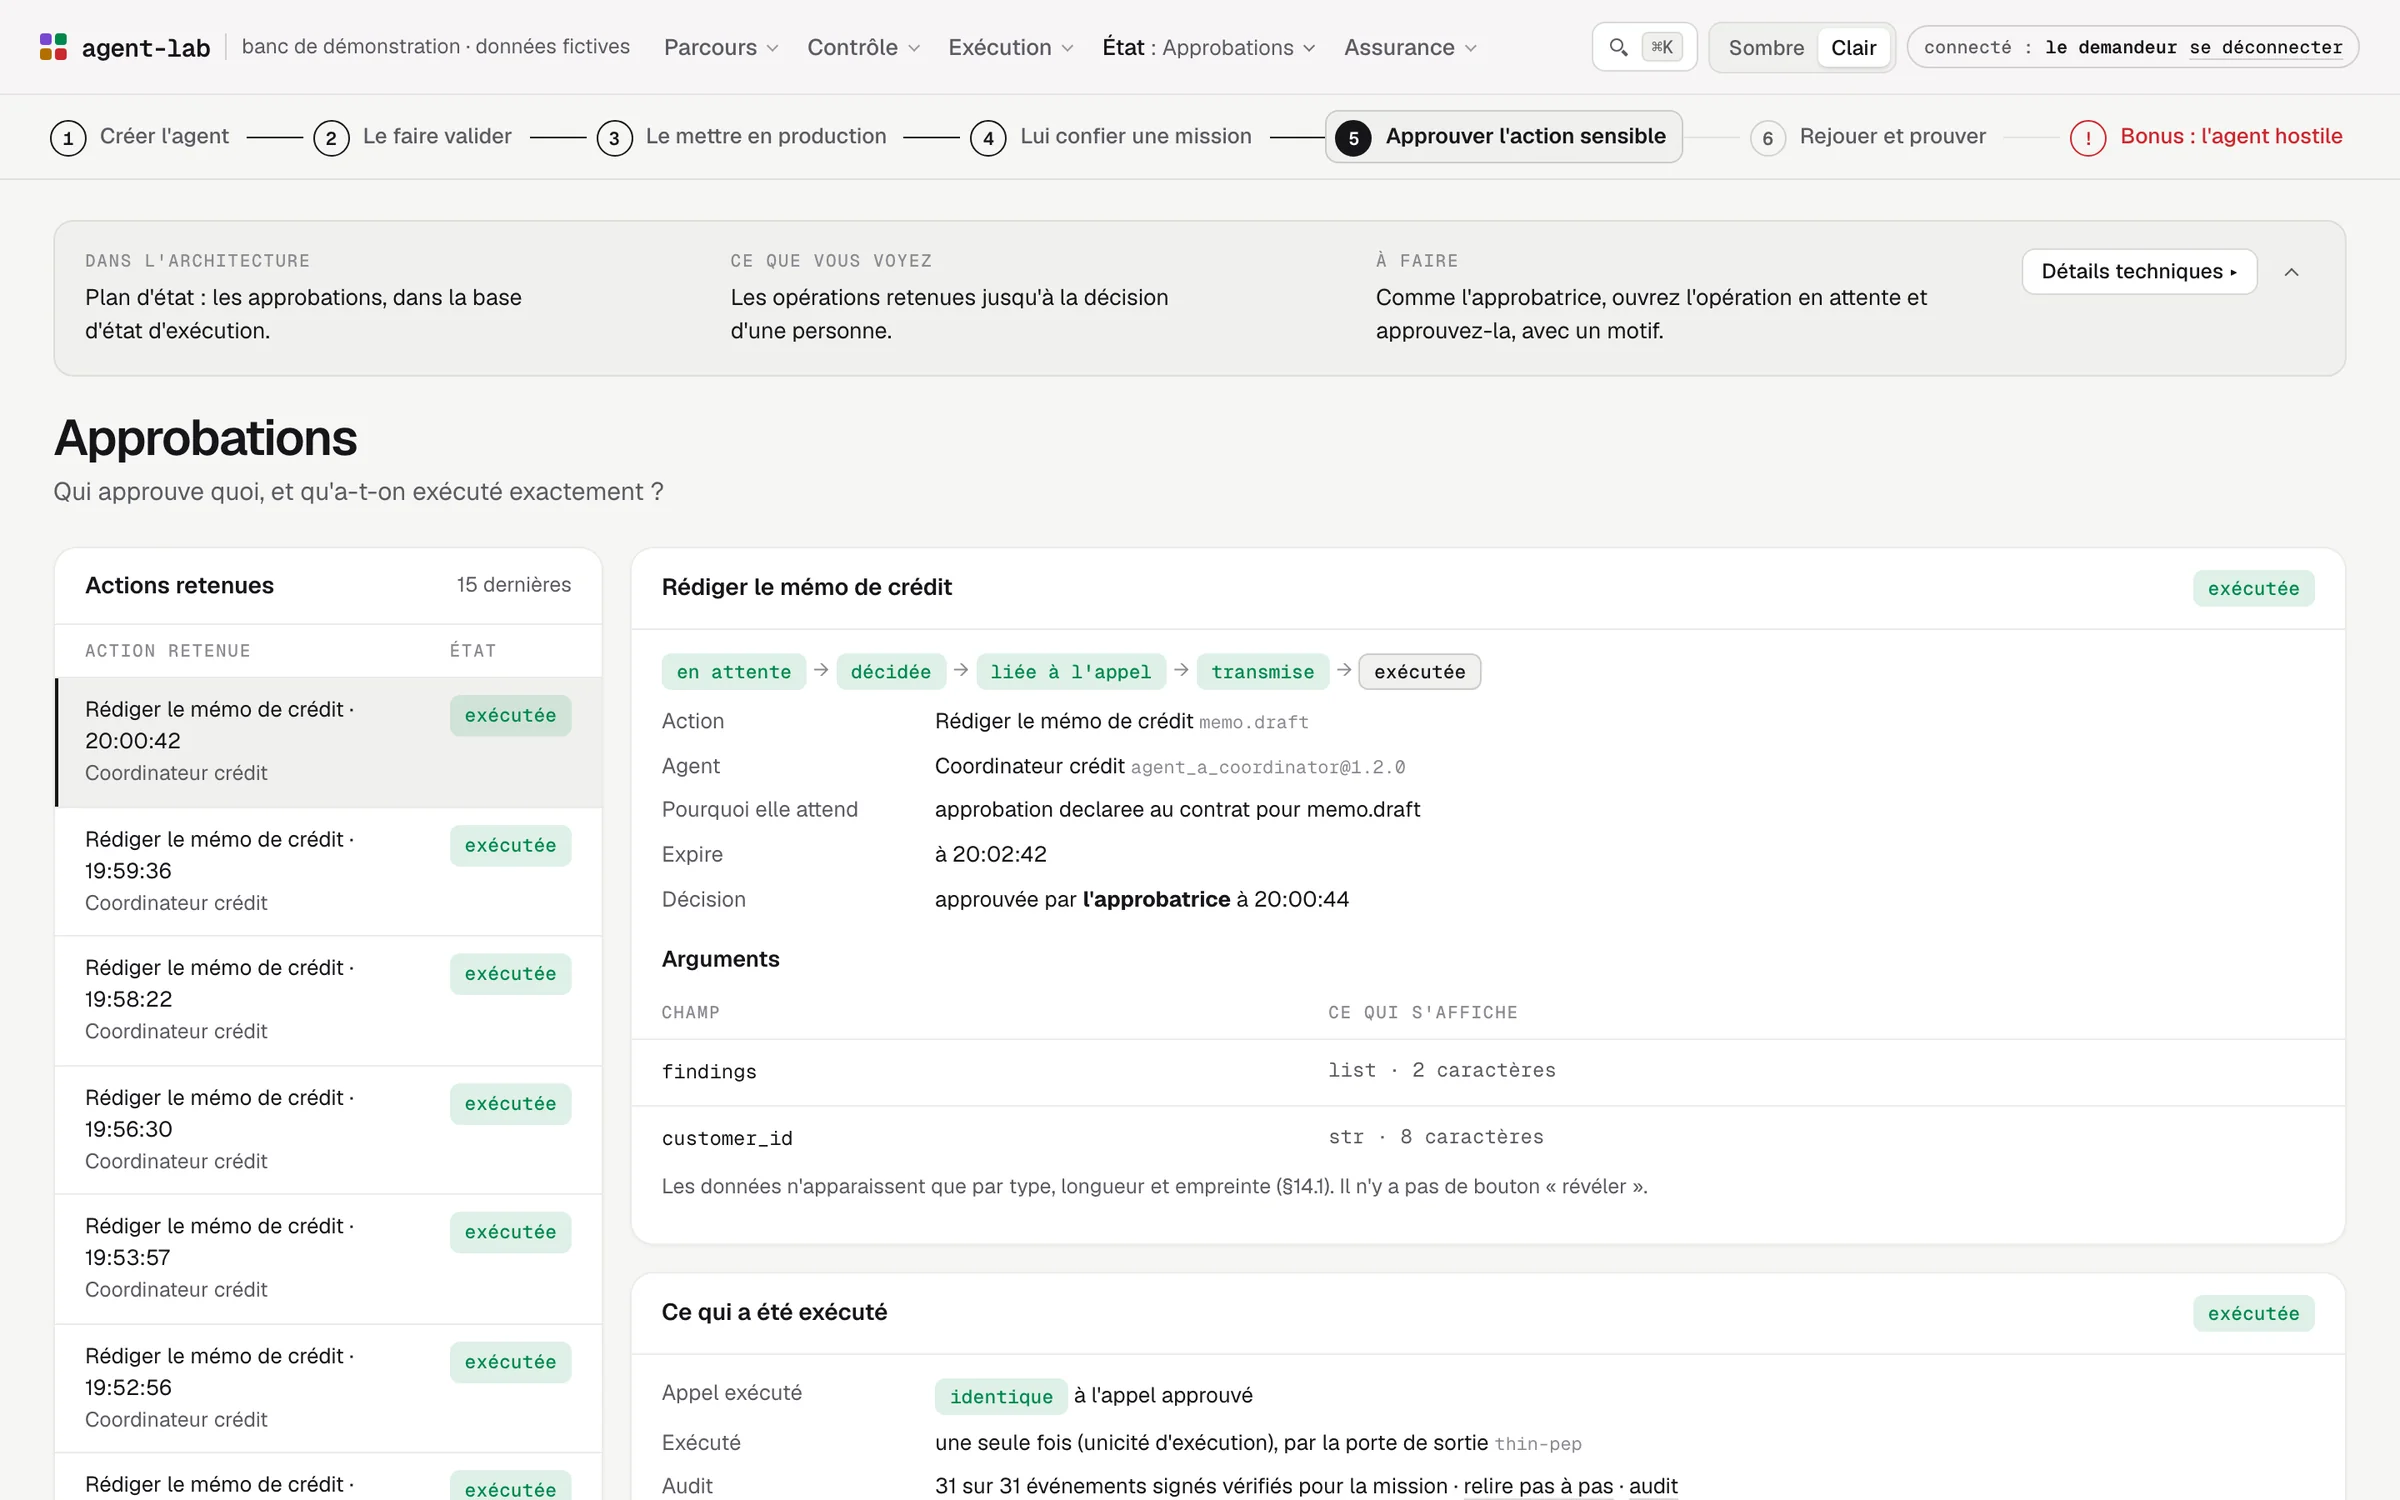
Approbations : l'appel exécuté est identique à l'appel approuvé, et exécuté une seule fois. Capture du banc, données fictives. -
Étape 6
Rejouer et prouver
On relit la mission dans l'audit signé : qui a décidé quoi, au nom de qui. Chaque événement est signé par le composant de confiance qui l'émet, avec sa propre clé ; aucun ne vient de l'agent.
Chaque signature se revérifie, et un événement falsifié apparaît invalide.
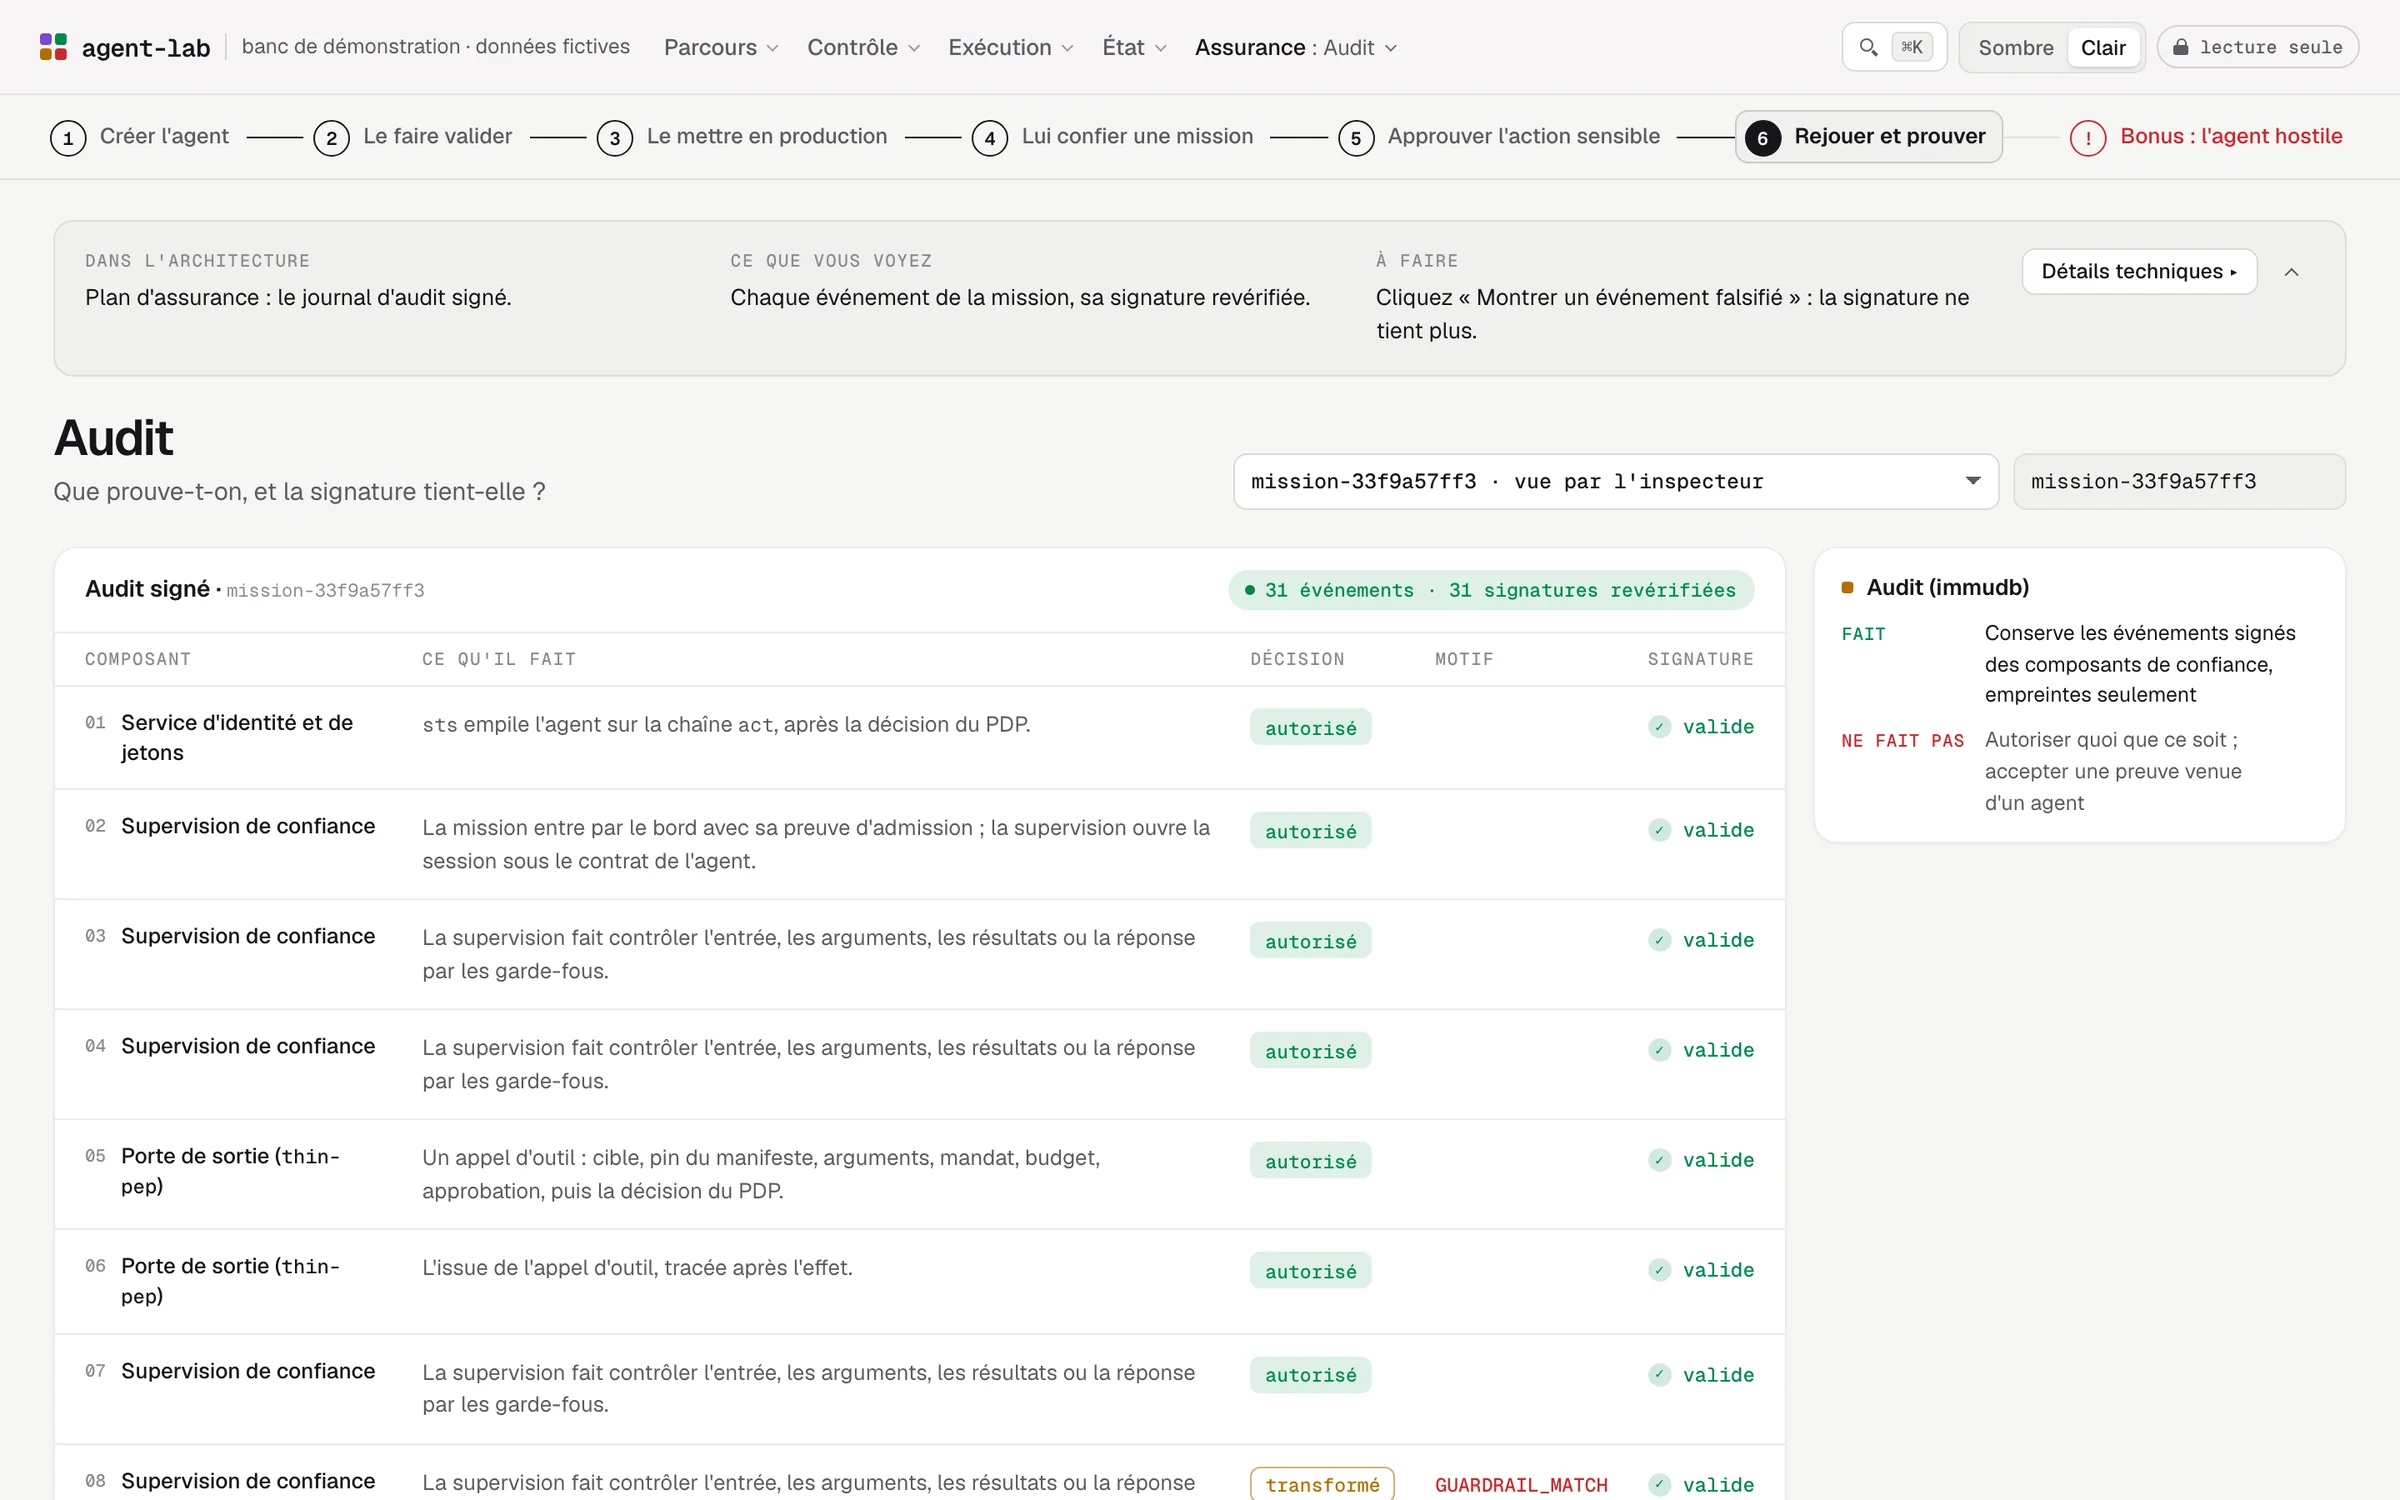
Audit : chaque événement est signé par le composant qui l'émet, et se revérifie. Capture du banc, données fictives.
Chaque brique de l'architecture a son écran.
Politique, entrée, agents, hébergement, supervision, model gateway, sortie, sessions, évaluation : chacun en lecture, rangé par plan. Trois d'entre eux.
-
Politique
Les règles en clair, porte par porte, et ce que chaque agent a le droit de faire, lu dans les contrats compilés. L'autorité effective est une intersection : le contrat de l'agent, ses habilitations, les droits de l'utilisateur.
On y teste une décision (un agent, une action, un montant) ; le moteur répond sans rien appliquer.
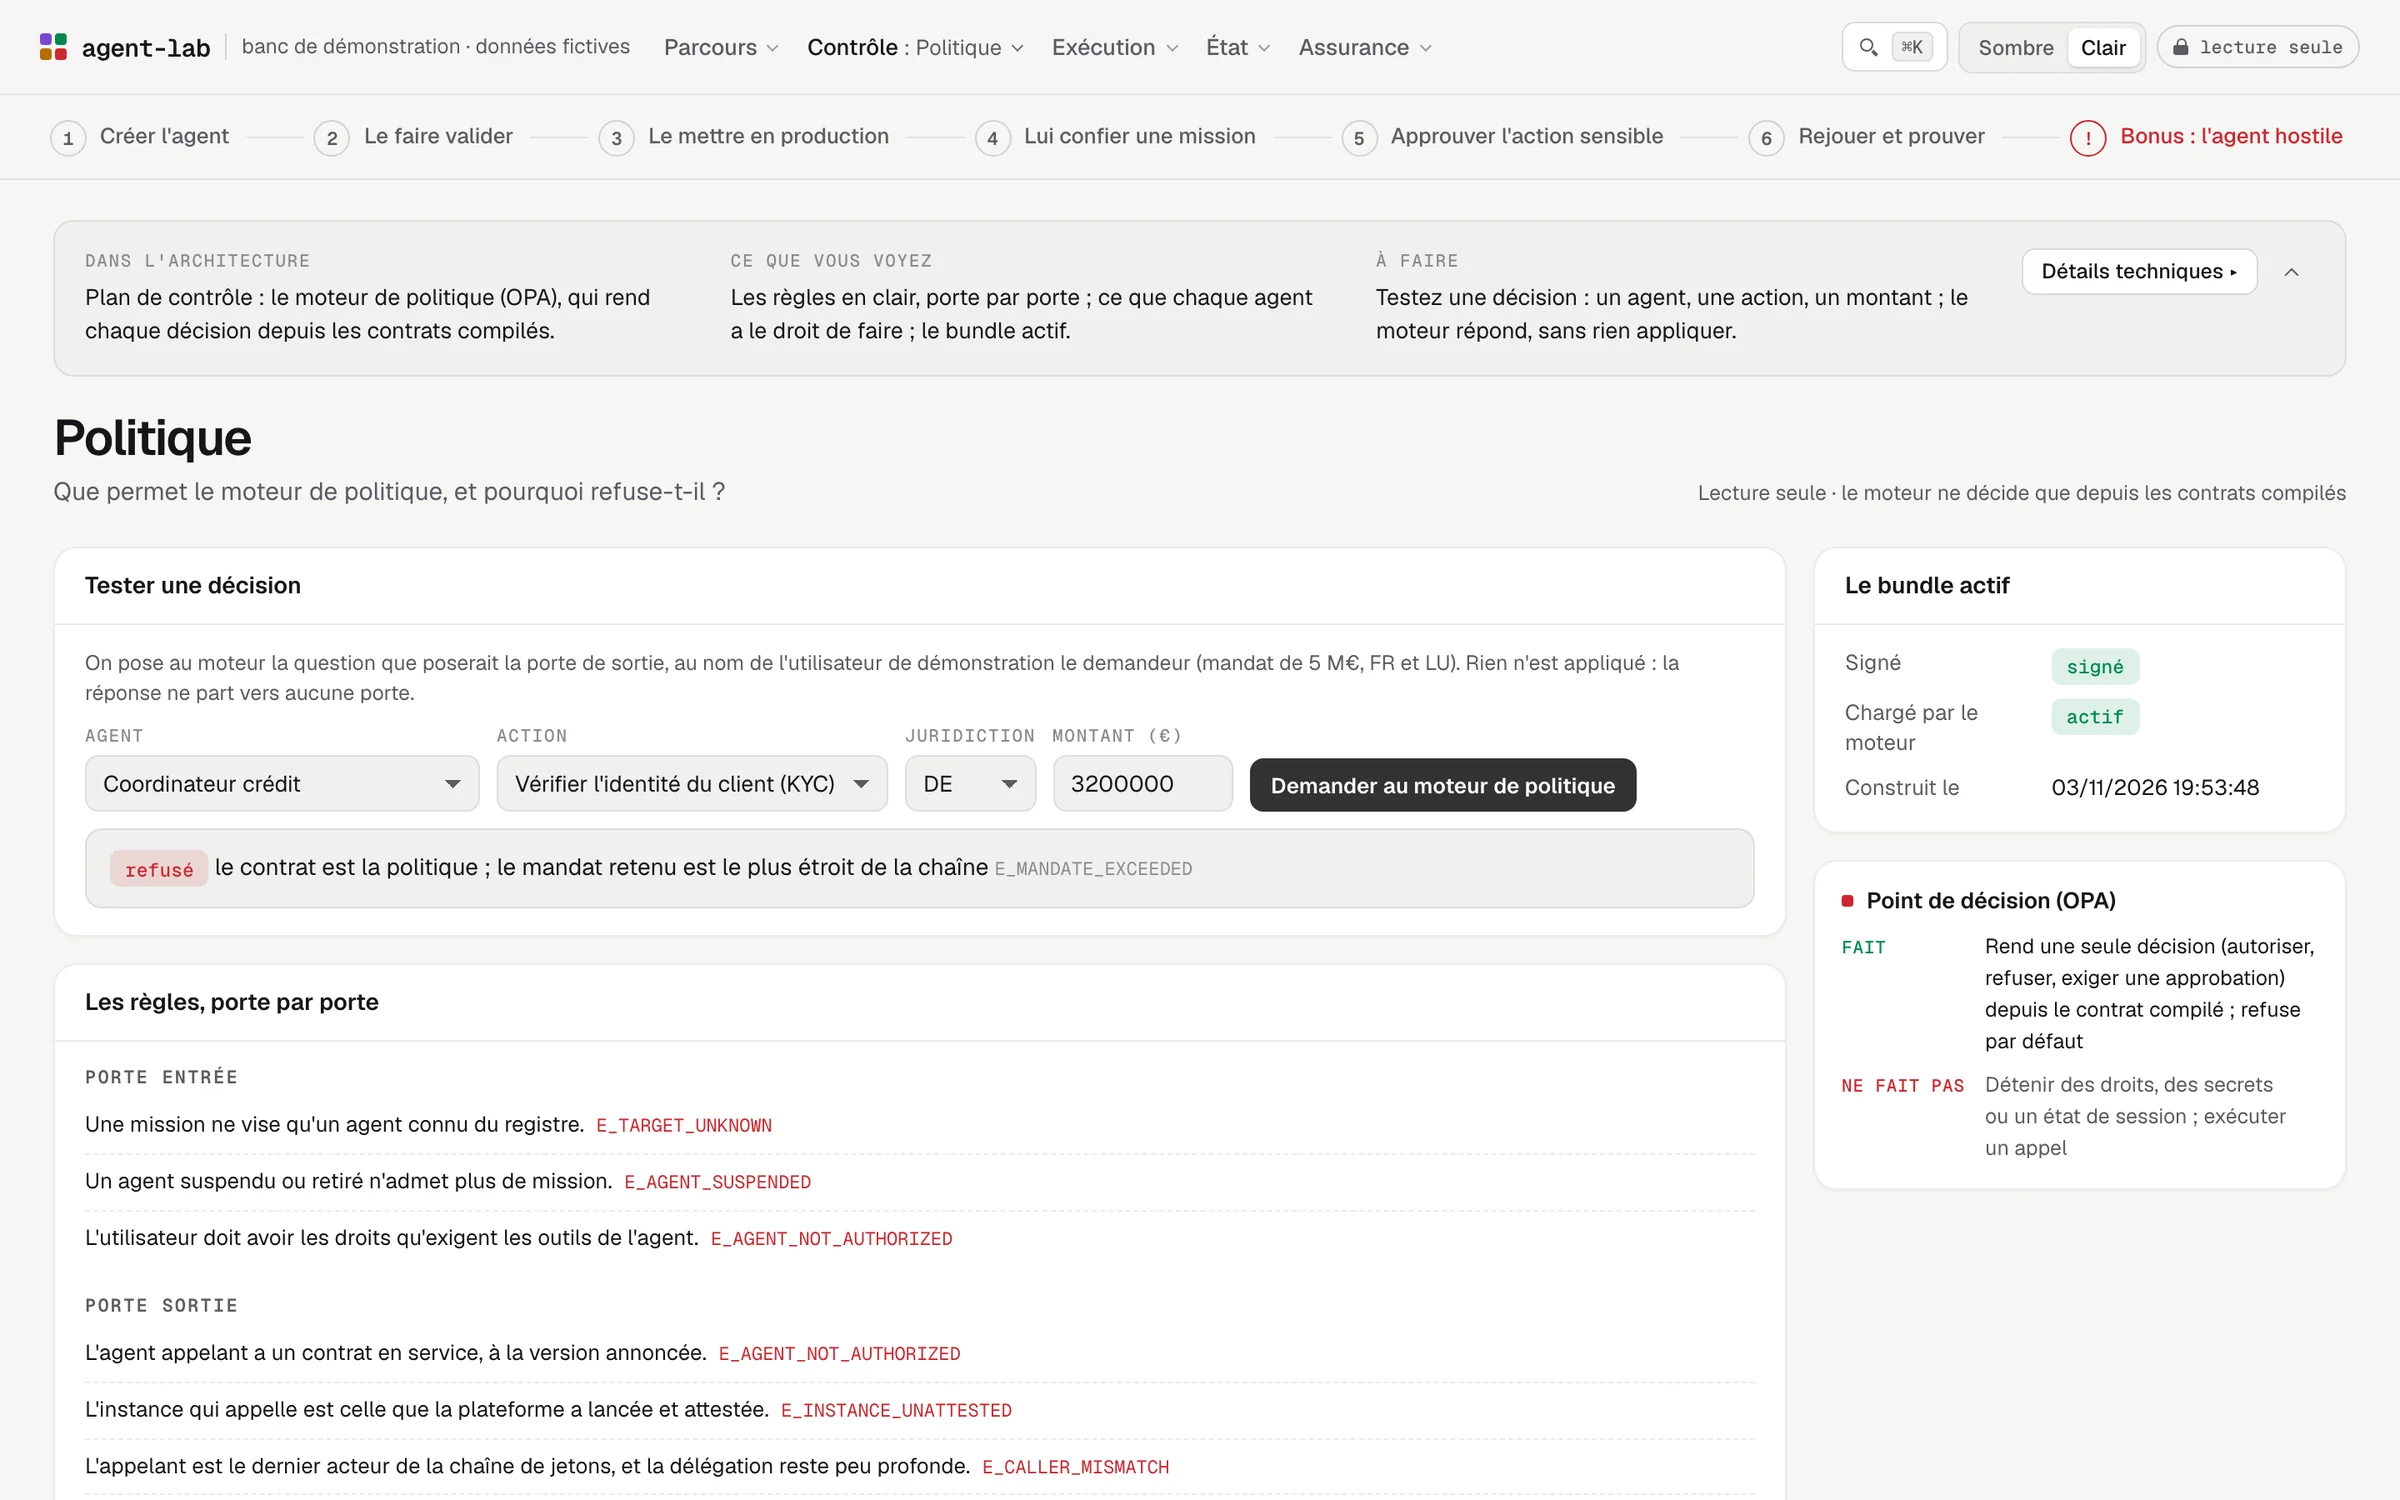
Politique : une décision testée, refusée hors mandat, et les règles porte par porte. Capture du banc, données fictives. -
Identité et chaîne OBO
Qui agit au nom de qui (on-behalf-of) : le jeton de l'utilisateur, échangé pour l'agent, puis pour l'agent qu'il appelle, selon la RFC 8693.
La chaîne d'acteurs se lit à l'écran, les jetons décodés et rédigés. Une délégation n'ajoute aucun droit.
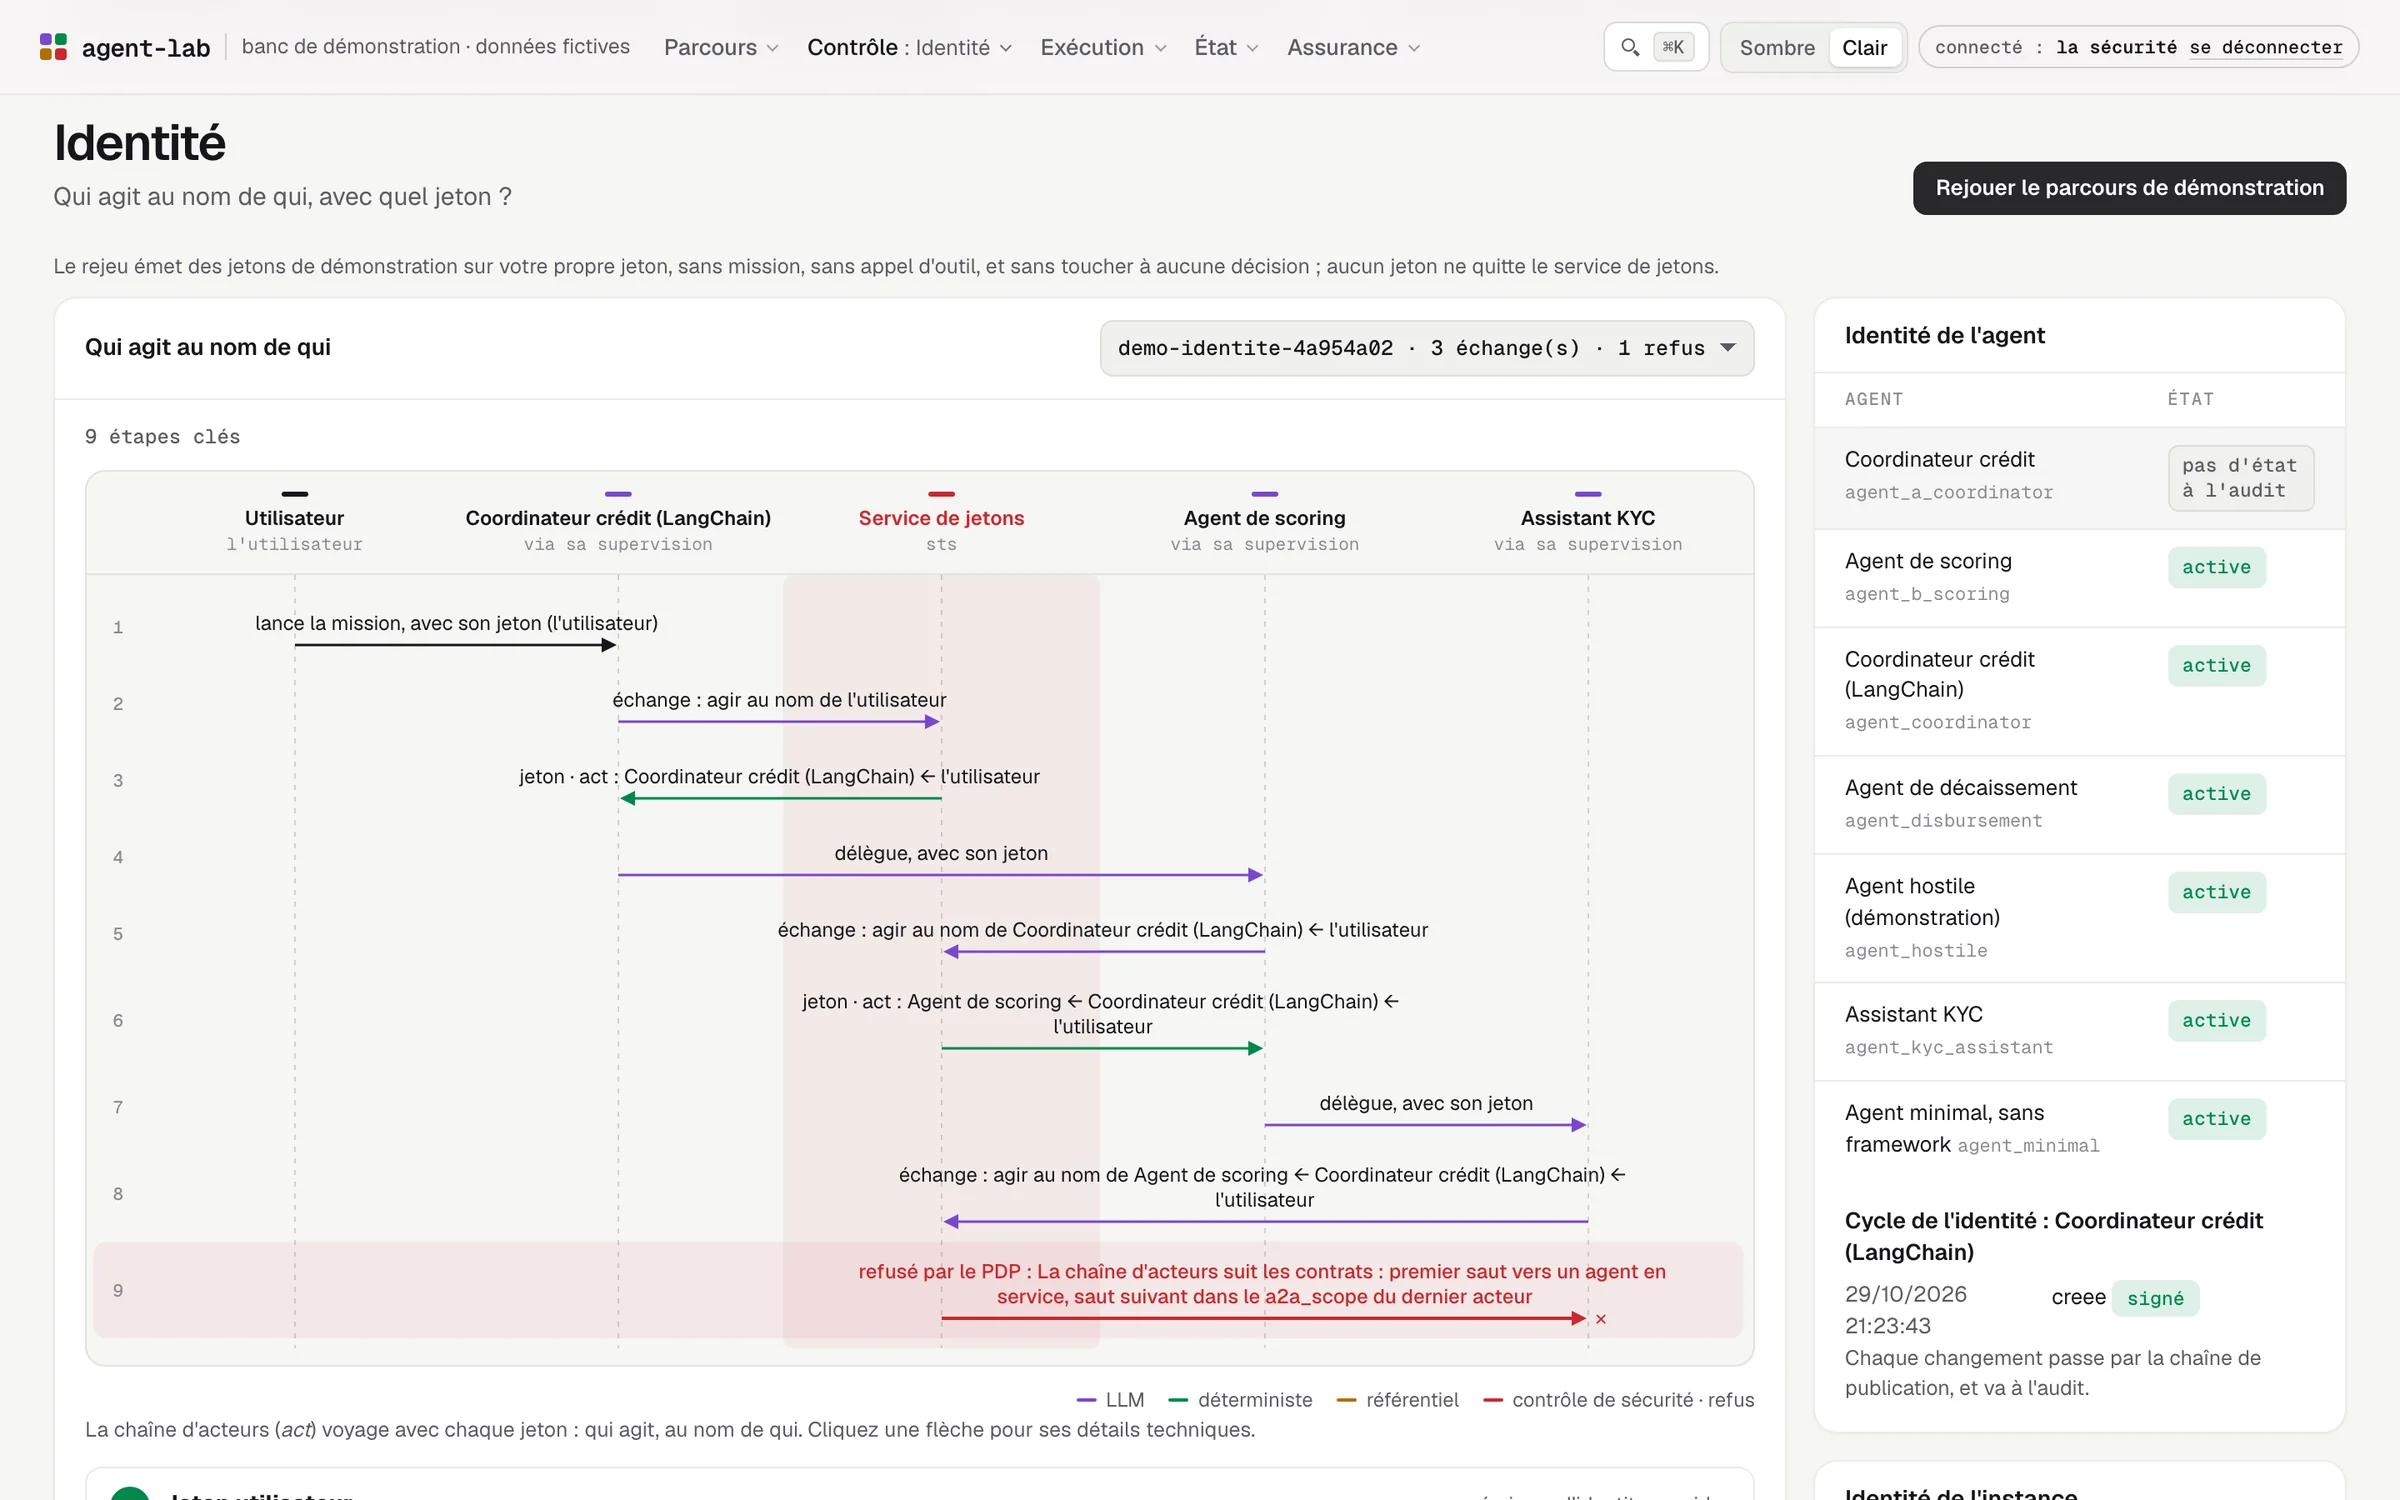
Identité : qui agit au nom de qui, à chaque échange de jeton ; un saut hors contrat est refusé. Capture du banc, données fictives. -
Évaluation pass^3 : trois succès sur trois
Chaque agent rejoue trois fois, indépendamment, ses missions de démonstration, et ne passe que s'il réussit les trois fois. C'est pass^3 (« pass puissance 3 »), au sens du benchmark τ-bench de Sierra : l'inverse de pass@3, où un seul succès sur trois suffit.
Un modèle de langage n'est pas déterministe : un agent qui réussit une fois sur trois n'est pas fiable en production. pass^3 mesure la régularité, pas la réussite ponctuelle. La mise en production lit ce résultat et refuse un agent qui ne passe pas.
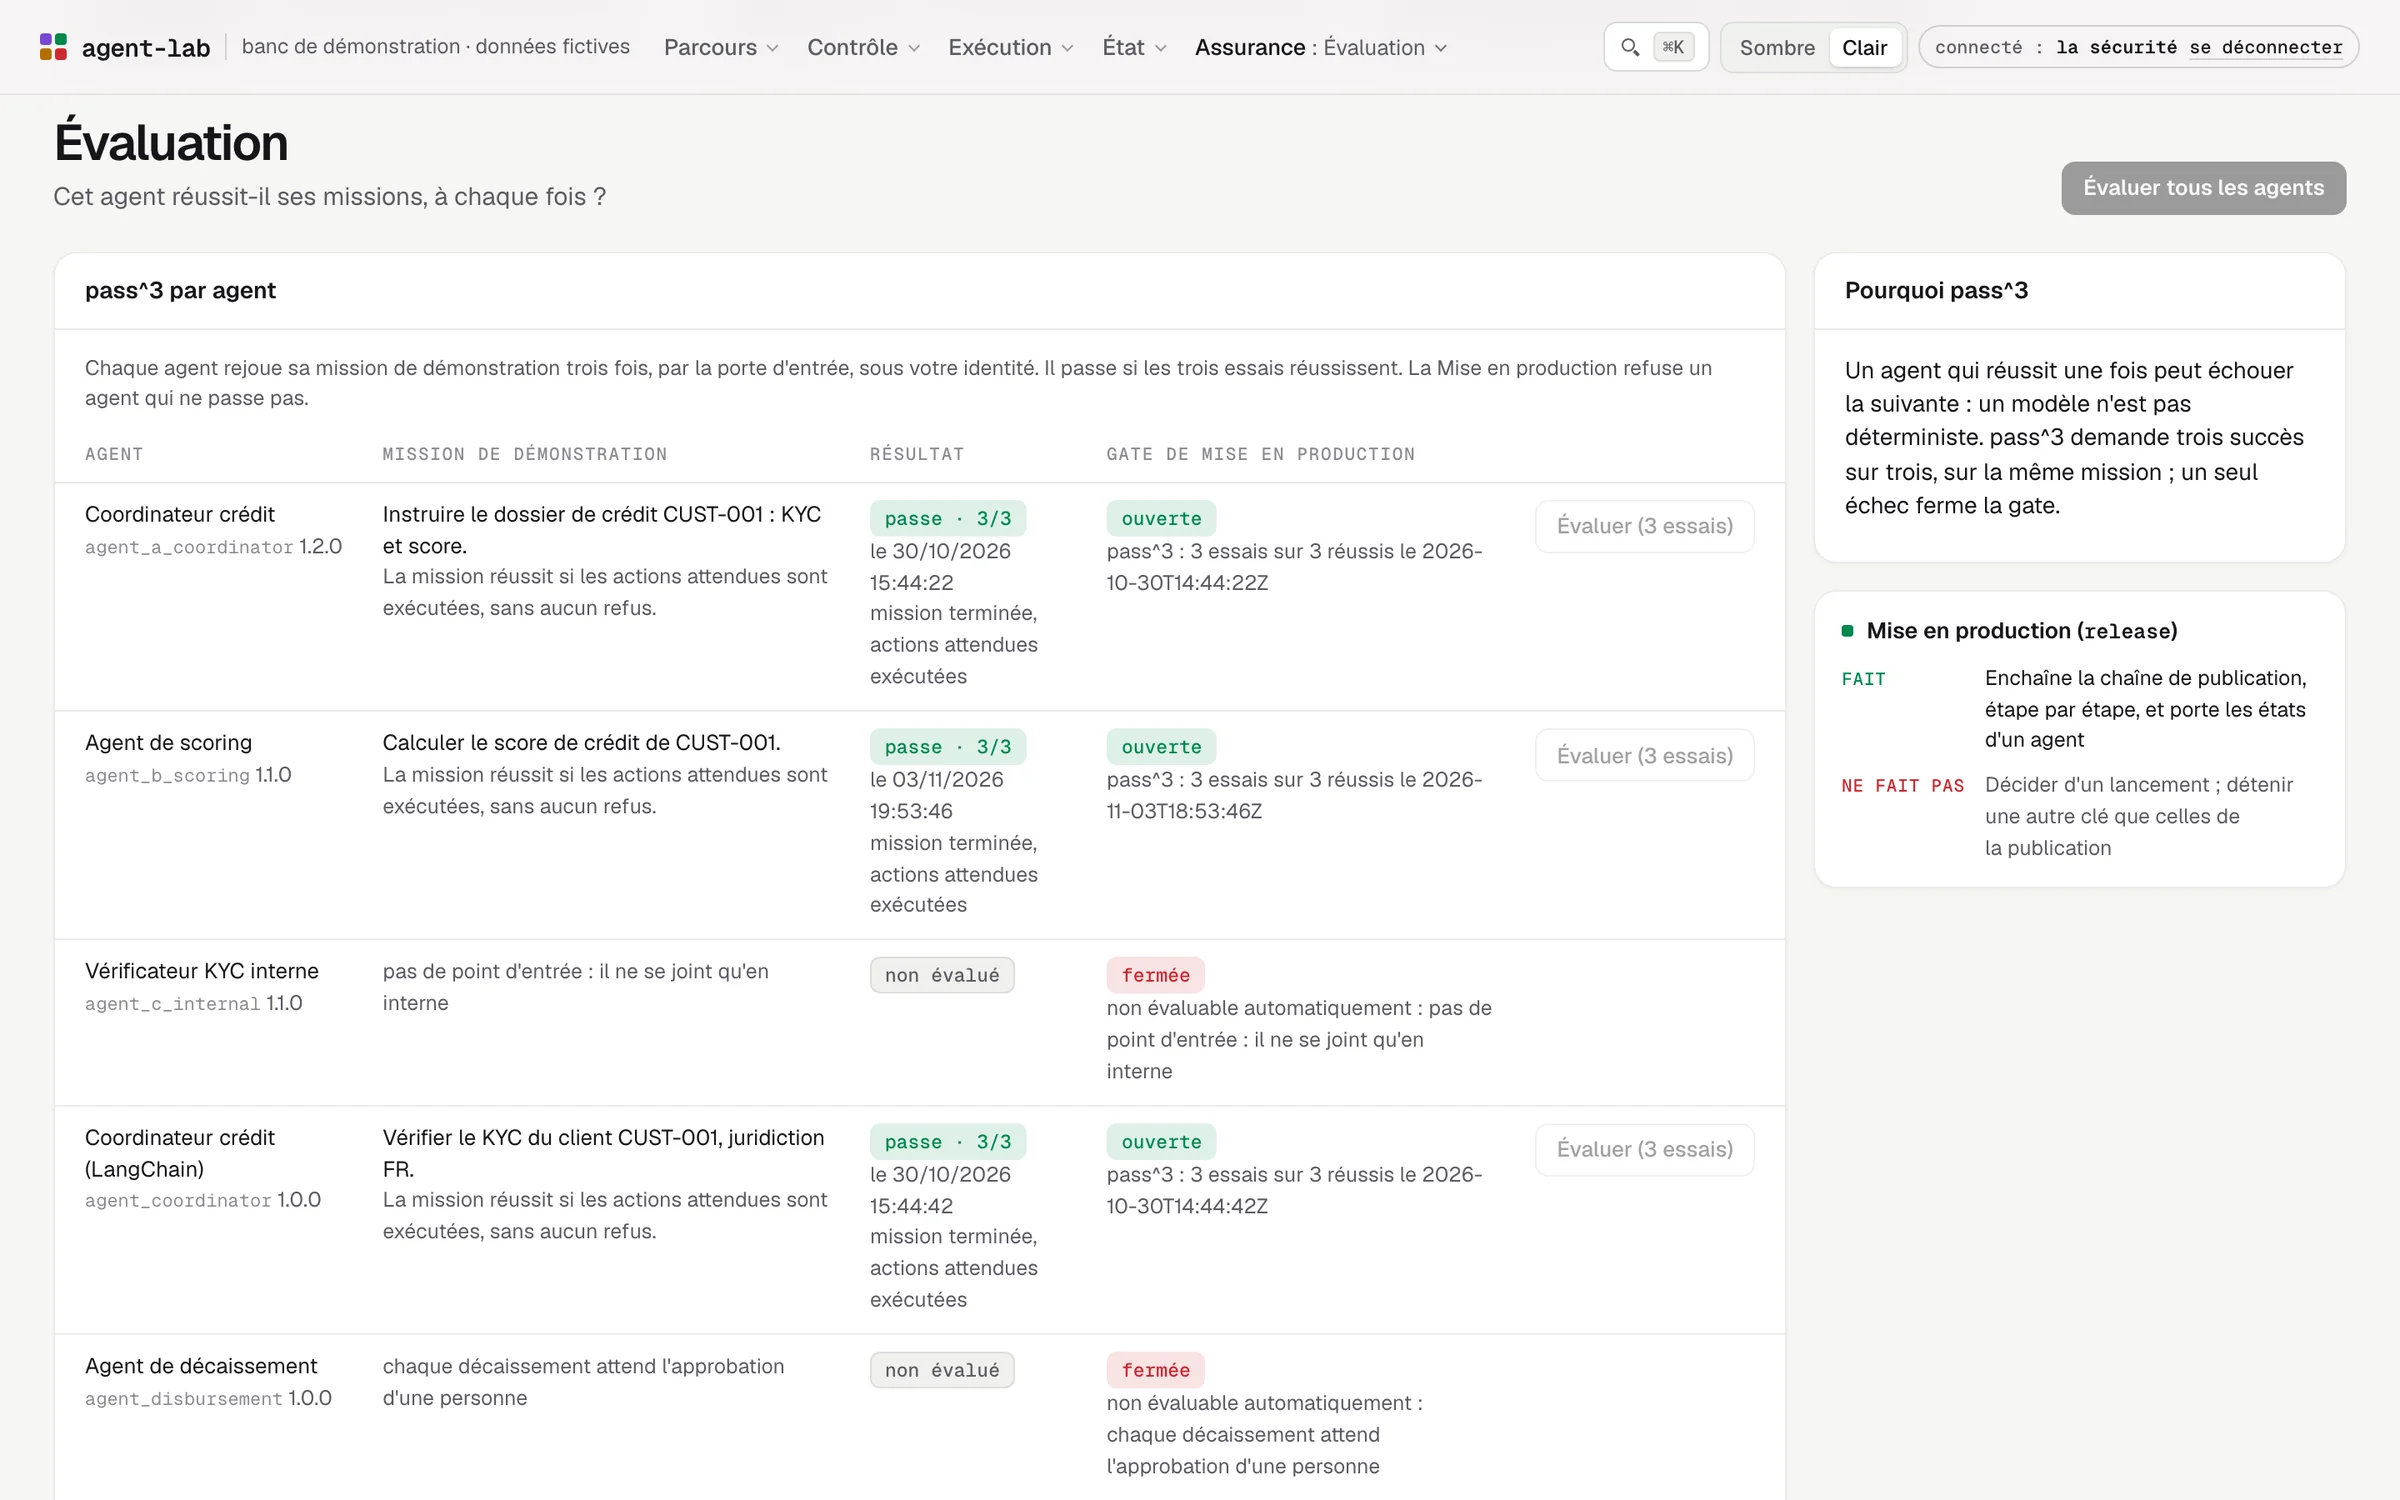
Évaluation : trois succès sur trois, ou la mise en production reste fermée. Capture du banc, données fictives.
Treize tentatives de contournement, toutes refusées hors de l'agent.
Un agent écrit pour tricher, avec LangChain comme le ferait une équipe métier, enchaîne ses tentatives dans une seule mission. Il essaie de :
- joindre en direct un serveur d'outils, la porte de sortie, le modèle, un autre agent ou l'audit ;
- signer un événement d'audit ou un contrat, sans clé ;
- entrer sans passer par la porte d'entrée ;
- demander un autre modèle que celui de son contrat ;
- remplacer son prompt système, en direct ou par un middleware ;
- appeler un outil hors de son contrat ;
- passer un argument que les garde-fous bloquent ;
- dépasser le mandat de l'utilisateur.
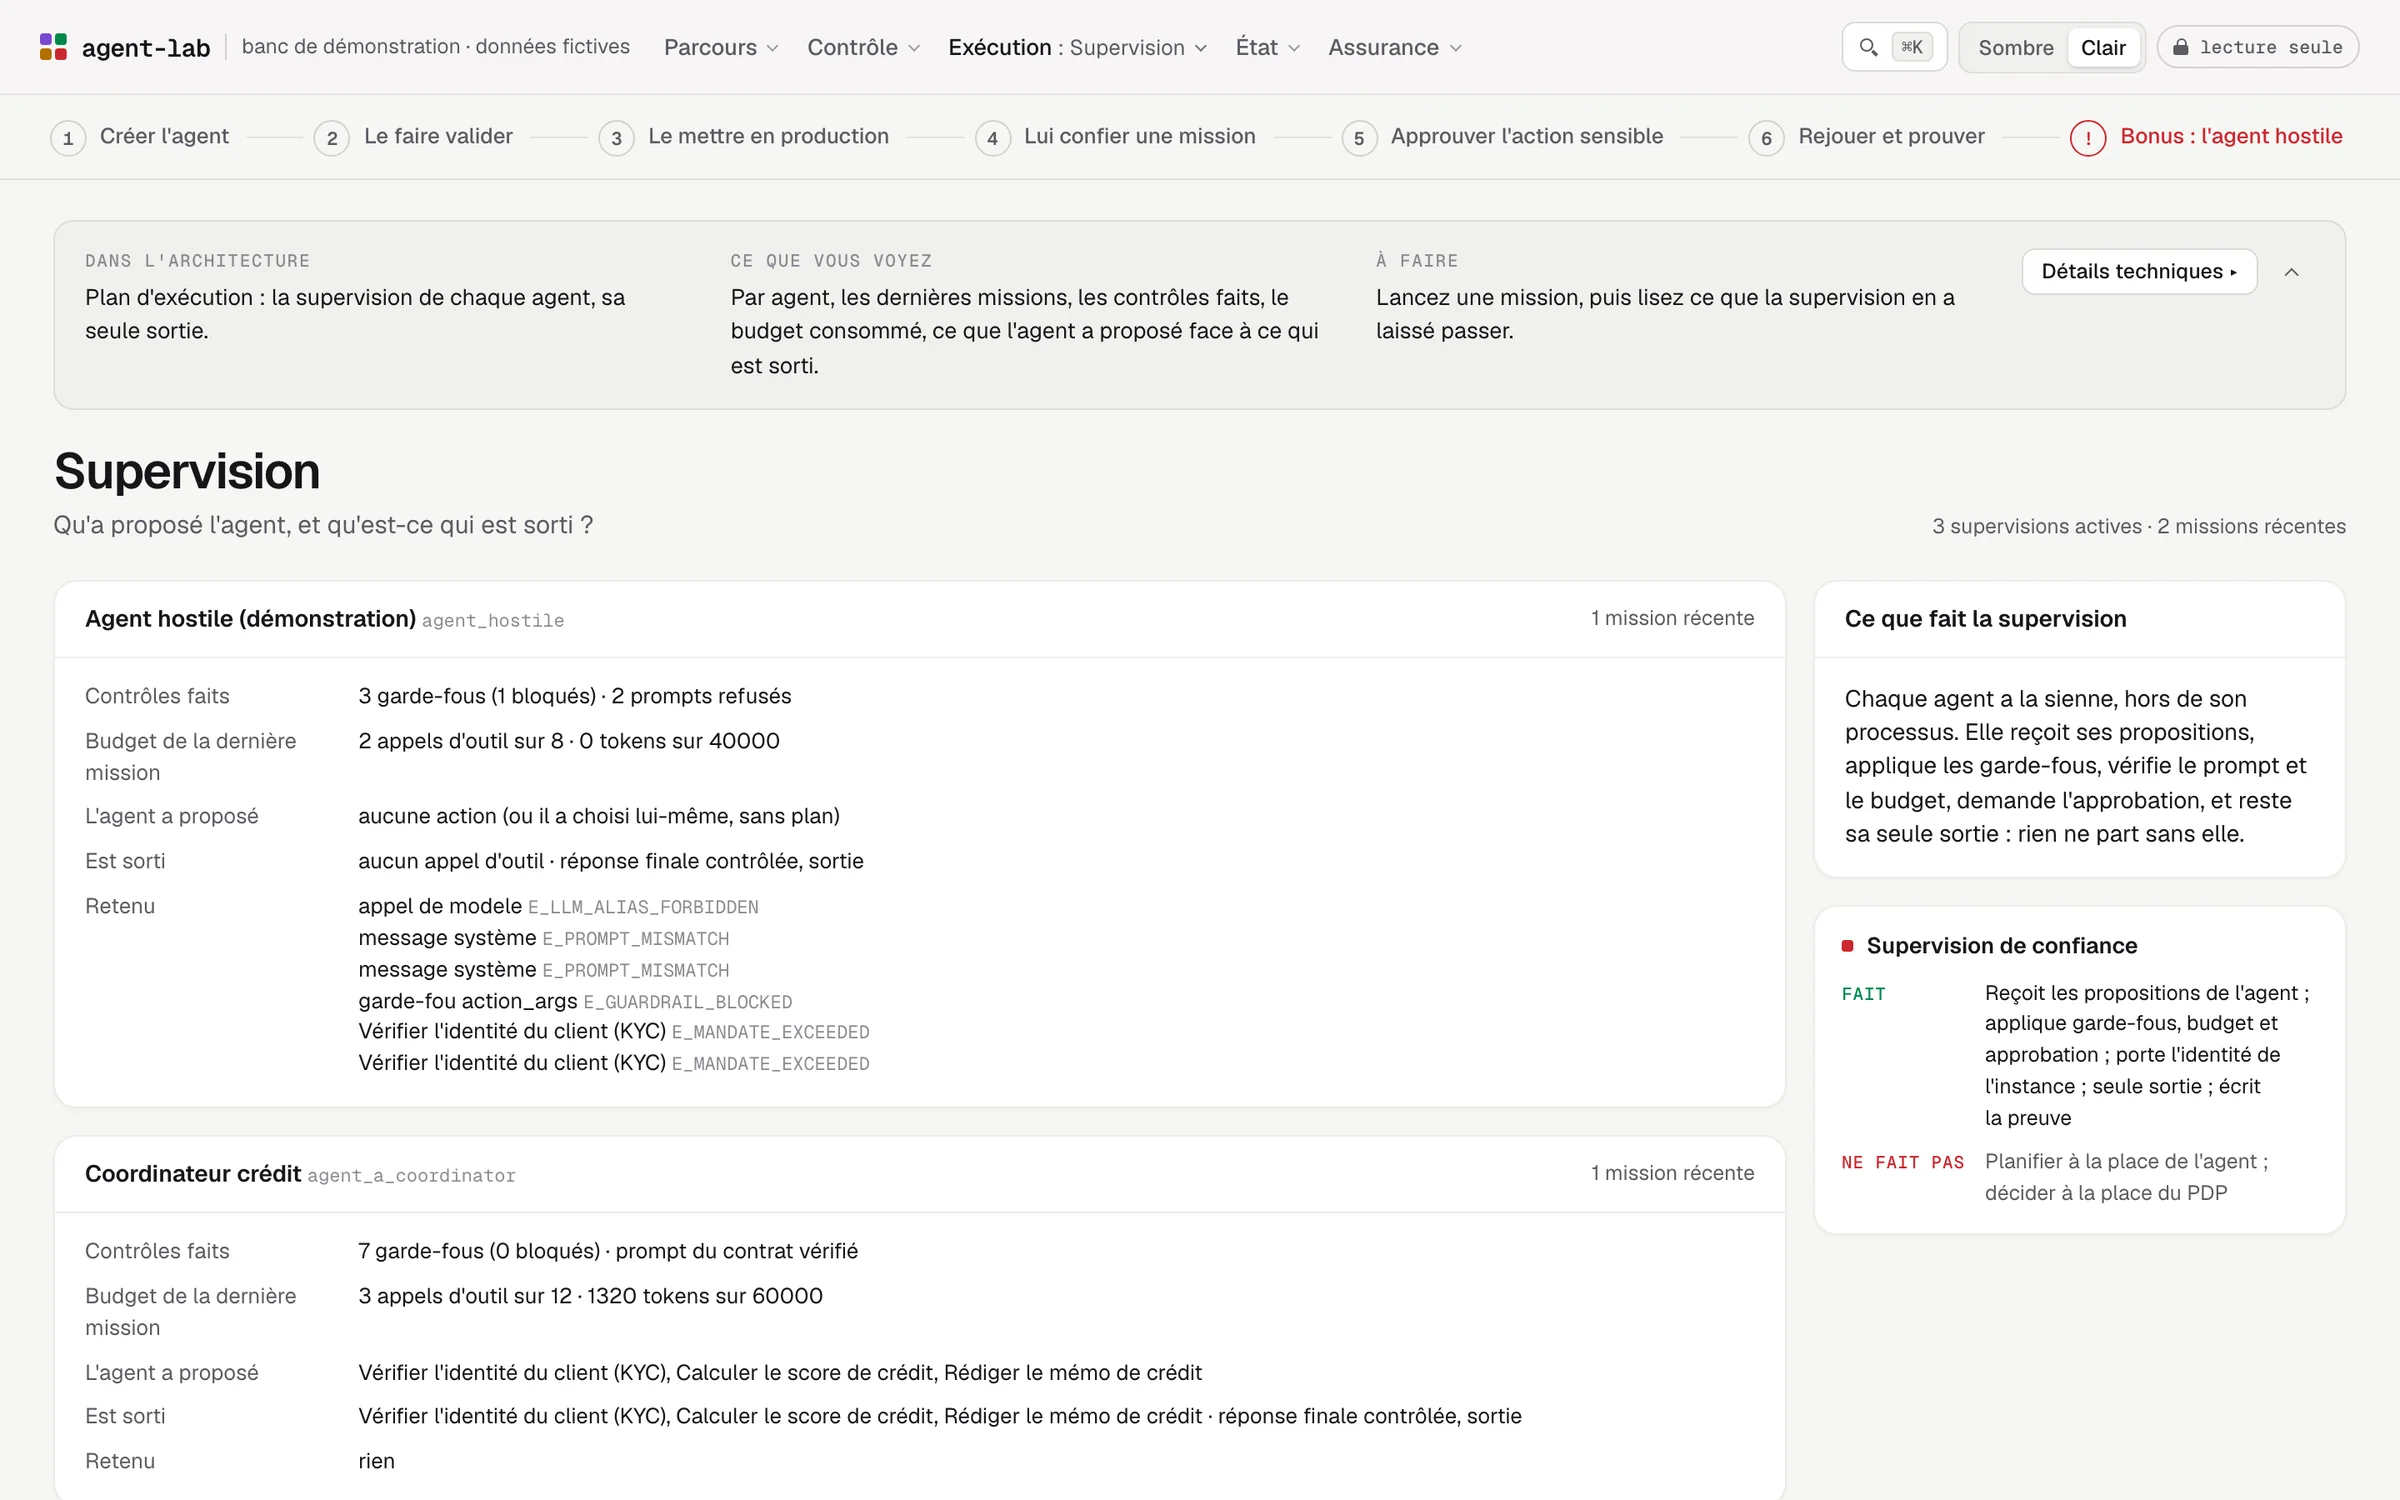
Chaque tentative est refusée par un composant hors de l'agent, et chaque refus est tracé dans l'audit signé. Sur l'écran Mission, une variante « mémo piégé » montre aussi le garde-fou de sortie : le serveur de mémo renvoie une injection de prompt, que la supervision bloque.
05 Sous le capot
- Docker Compose
- toute la plateforme sur un poste, sans dépendance cloud.
- Envoy et OPA
- la porte d'entrée, et le moteur de politique, qui charge en bundle signé une politique compilée depuis les contrats.
- Keycloak et un service de jetons RFC 8693
- les identités des utilisateurs et des agents, et l'échange de jetons qui porte la chaîne d'acteurs.
- LangGraph, LangChain create_agent et un agent sans framework
- trois runtimes sous le même contrat et la même supervision.
- Une supervision hors du processus de l'agent, en MCP
- sa seule sortie vers le modèle et vers les outils.
- Une model gateway devant des modèles locaux
- le modèle du contrat et le budget de tokens, tenus hors de l'agent.
- Un audit signé (immudb, ed25519)
- une clé par composant de confiance, des signatures revérifiables hors ligne.
- PostgreSQL et OpenTelemetry
- l'état d'exécution, et les traces de chaque mission.
06 Ce que ce banc n'est pas
Concevoir l'autorité de vos agents.
La formation Architecture d'agents part des mêmes principes : un contrat d'agent signé, une politique « refus par défaut » testée sur cas, une méthode pour modéliser l'autorité effective.